

Confidentialité des Données & Conformité
8 min de lecture
Mis à jour le :
Sep 22, 2026
IA souveraine : architecture complète, exemples pratiques et guide de mise en œuvre
Comprenez ce qu'est l'IA souveraine, comment fonctionne la pile à quatre couches, découvrez des exemples européens concrets (Mistral, Scaleway, BgGPT) et apprenez à atteindre une véritable souveraineté des données.

La plupart des acheteurs de logiciels d'entreprise pensent que le choix d'un centre de données européen garantit la souveraineté de leur intelligence artificielle.
En pratique, l'emplacement physique n'est qu'une partie de l'équation. Un serveur situé à Paris, exploité par une société du Delaware et interrogeant une API de modèle hébergée en Virginie, reste soumis aux injonctions américaines, quel que soit le drapeau qui flotte sur le centre de données.
Ce guide définit ce qu'est réellement l'IA souveraine, détaille les quatre couches distinctes de la pile de souveraineté, passe en revue les modèles et fournisseurs d'infrastructure européens existants, examine les initiatives nationales à travers le continent et trace une feuille de route de 30 jours pour auditer et sécuriser les flux de travail de votre entreprise.
1. Qu'est-ce que l'IA souveraine ?
L'IA souveraine désigne des systèmes d'intelligence artificielle conçus, hébergés, exploités et gouvernés au sein d'une juridiction légale spécifique. Elle garantit qu'une organisation ou une nation conserve une autorité totale sur ses données, ses poids de modèles, son infrastructure de calcul et ses flux opérationnels, sans exposition aux lois étrangères ou aux mandats d'accès externes.
2. La pile de souveraineté à quatre couches
Un système d'IA classique se compose de quatre couches indépendantes. Chaque couche peut se situer dans une juridiction différente. Lorsqu'un fournisseur revendique un « hébergement dans l'UE », il fait presque toujours référence à la seule couche 1.
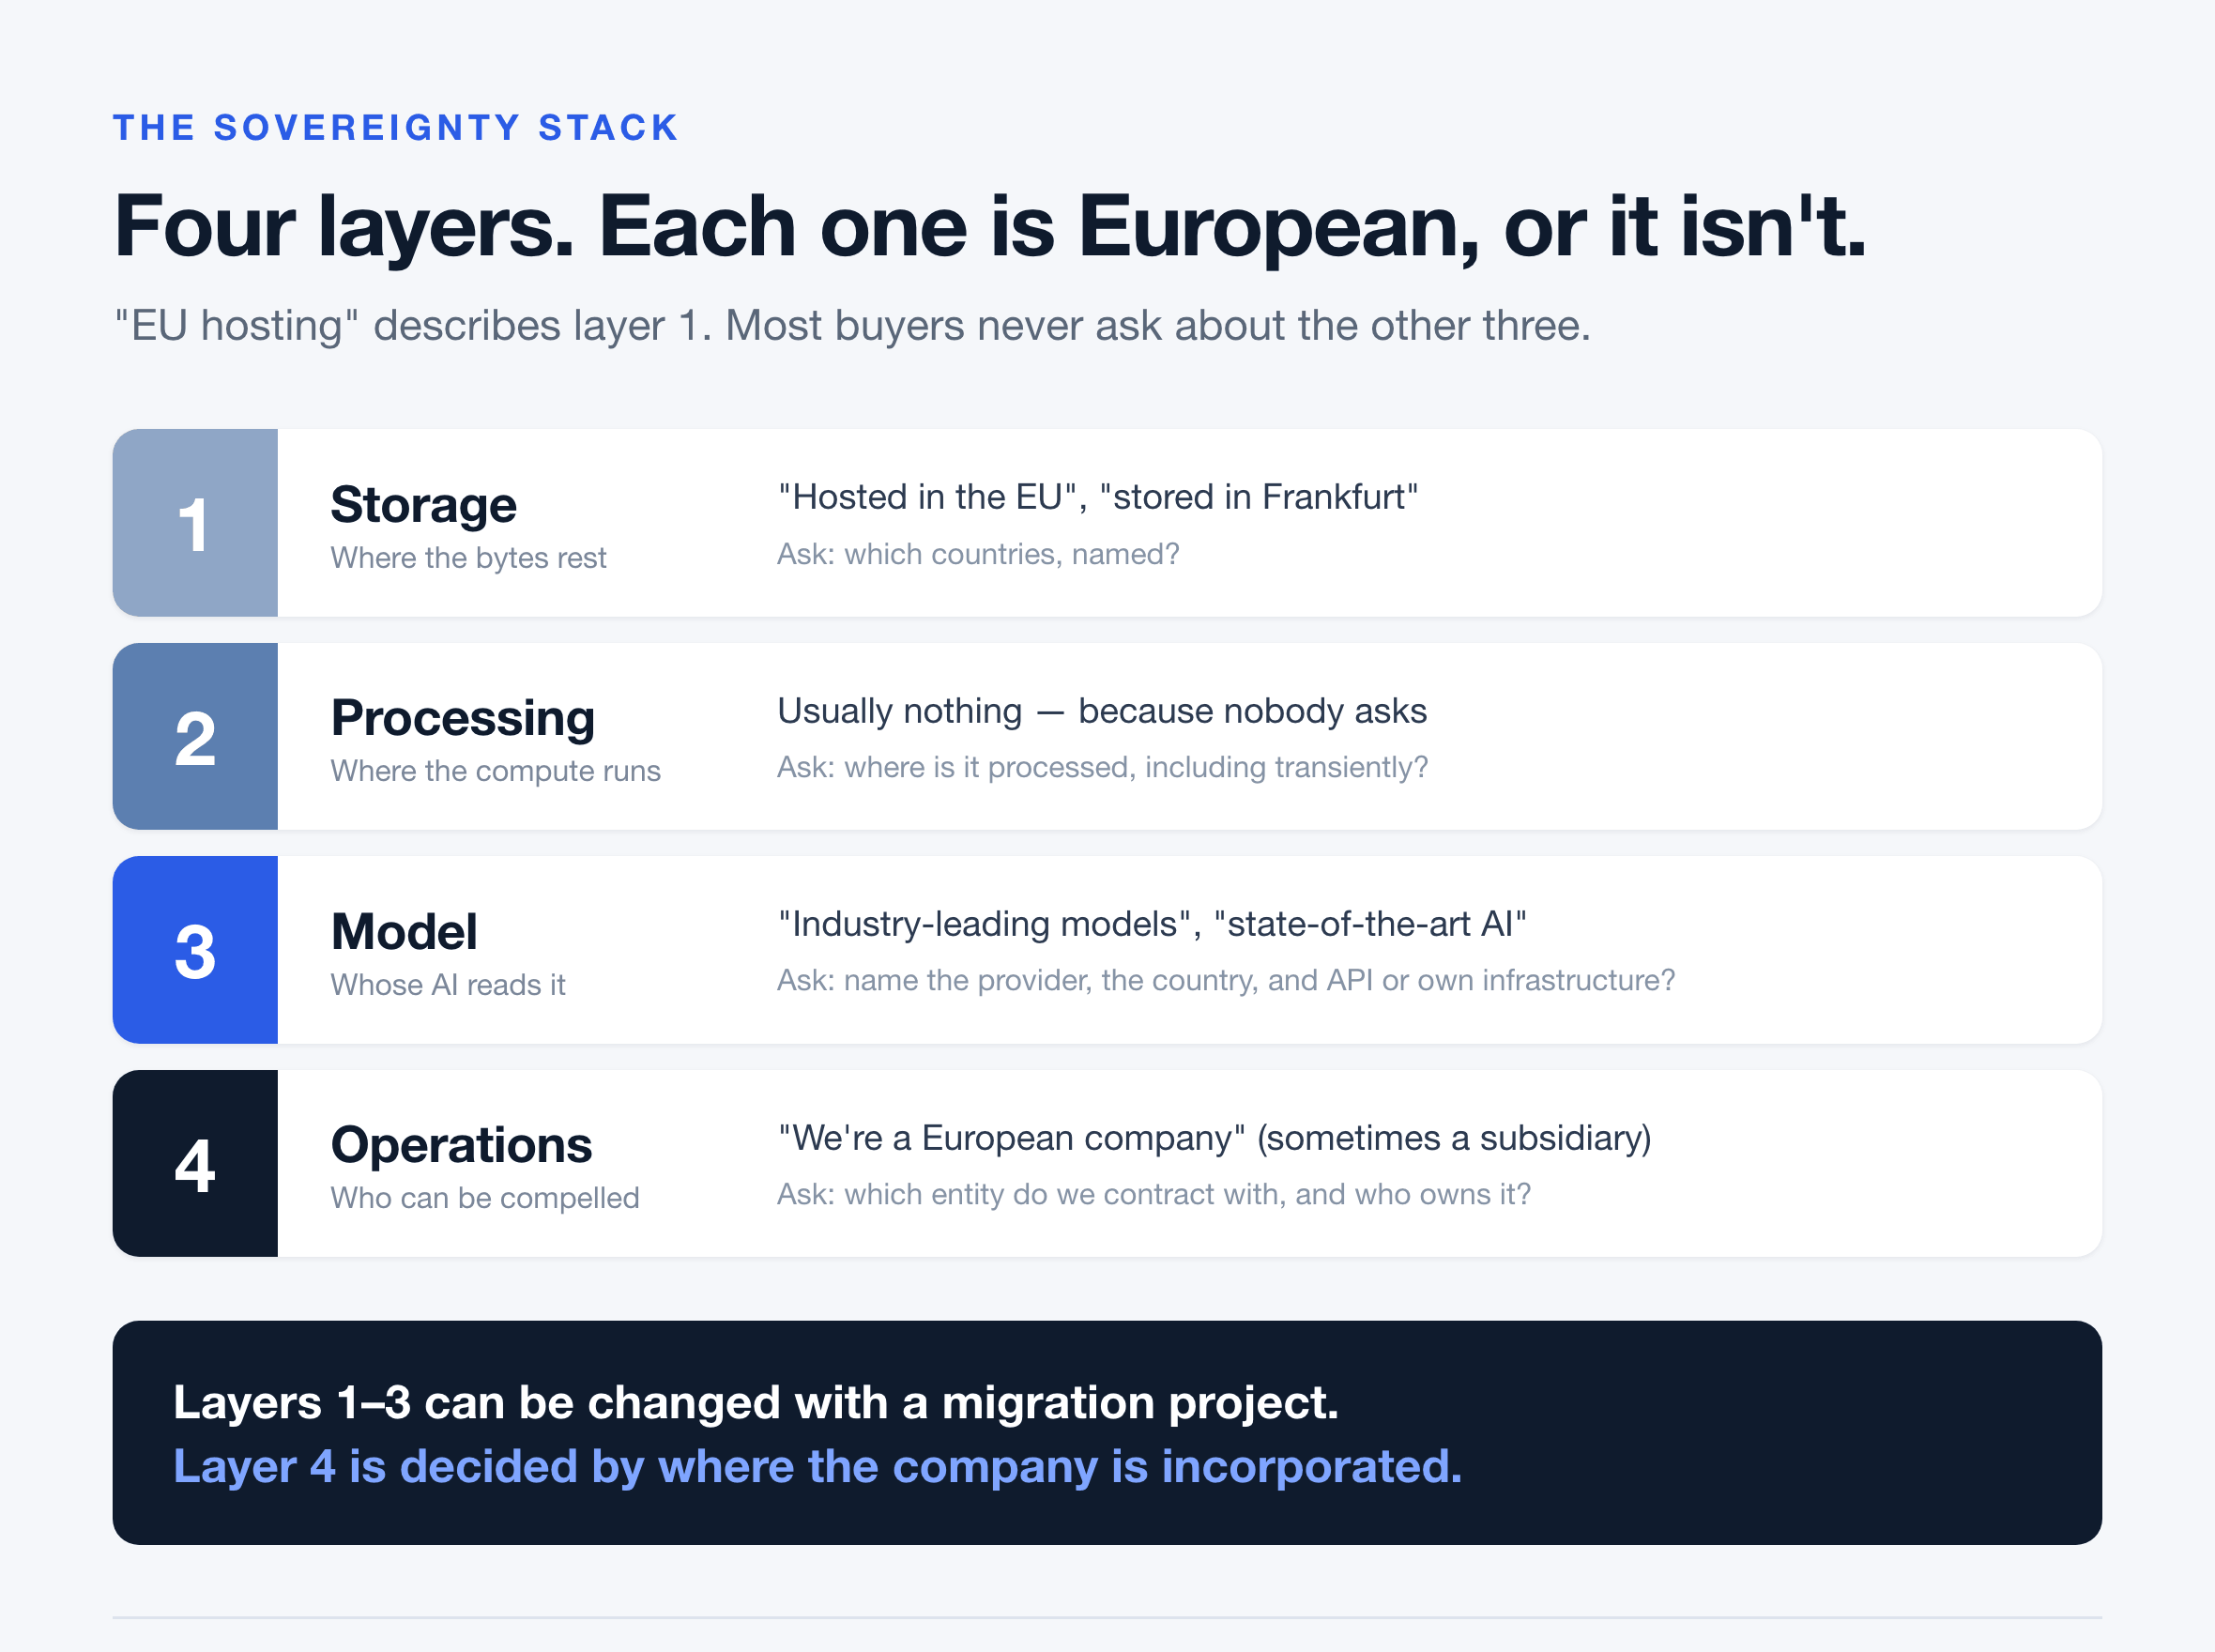
Couche 1 : Stockage (données au repos)
Cela concerne les disques durs et les clusters de bases de données contenant des fichiers, des enregistrements et des transcriptions archivées. Bien que les régions cloud européennes soient largement disponibles auprès de tous les grands hyperscalers, l'emplacement du stockage n'offre aucune protection contre les procédures judiciaires étrangères si la société mère est constituée à l'étranger.
Couche 2 : Traitement (données en transit)
Les données sont souvent stockées en Europe, mais sont acheminées à l'international lors de leur exécution. Le traitement de la parole en texte, la synthèse, la recherche vectorielle et la télémétrie analytique s'exécutent fréquemment sur des clusters de serveurs disparates. En vertu du RGPD, chaque saut de transit transfrontalier constitue un transfert international de données nécessitant un mécanisme juridique valide.
Couche 3 : Modèle et inférence
La couche modèle est celle où le contenu intégral de vos données professionnelles est lu en clair. Lorsqu'une application interroge l'API d'un modèle tiers, vos données quittent l'infrastructure de l'application pour entrer dans le pipeline de traitement du fournisseur du modèle.
Il existe ici une distinction architecturale essentielle :
- Modèles à poids ouverts sur une infrastructure de calcul européenne privée : Les poids du modèle s'exécutent sur des instances européennes dédiées. Les données ne quittent jamais votre environnement contrôlé.
- Appels d'API tiers : Chaque requête quitte le réseau de votre fournisseur pour entrer dans le cloud d'un tiers, lié par les conditions opérationnelles et la juridiction de ce dernier.
Couche 4 : Opérations d'entreprise et juridiction légale
La couche 4 est structurelle. Elle dépend du lieu d'incorporation du fournisseur de logiciels, de l'identité de la société mère, du détenteur des clés cryptographiques et des employés disposant d'un accès administrateur root aux systèmes de production. Une filiale européenne d'une entité étrangère reste légalement soumise aux ordres des tribunaux du pays d'origine de sa société mère.
3. L'échelle de souveraineté à 5 niveaux
Les organisations peuvent déterminer leur position réelle en comparant leurs applications à cette échelle :
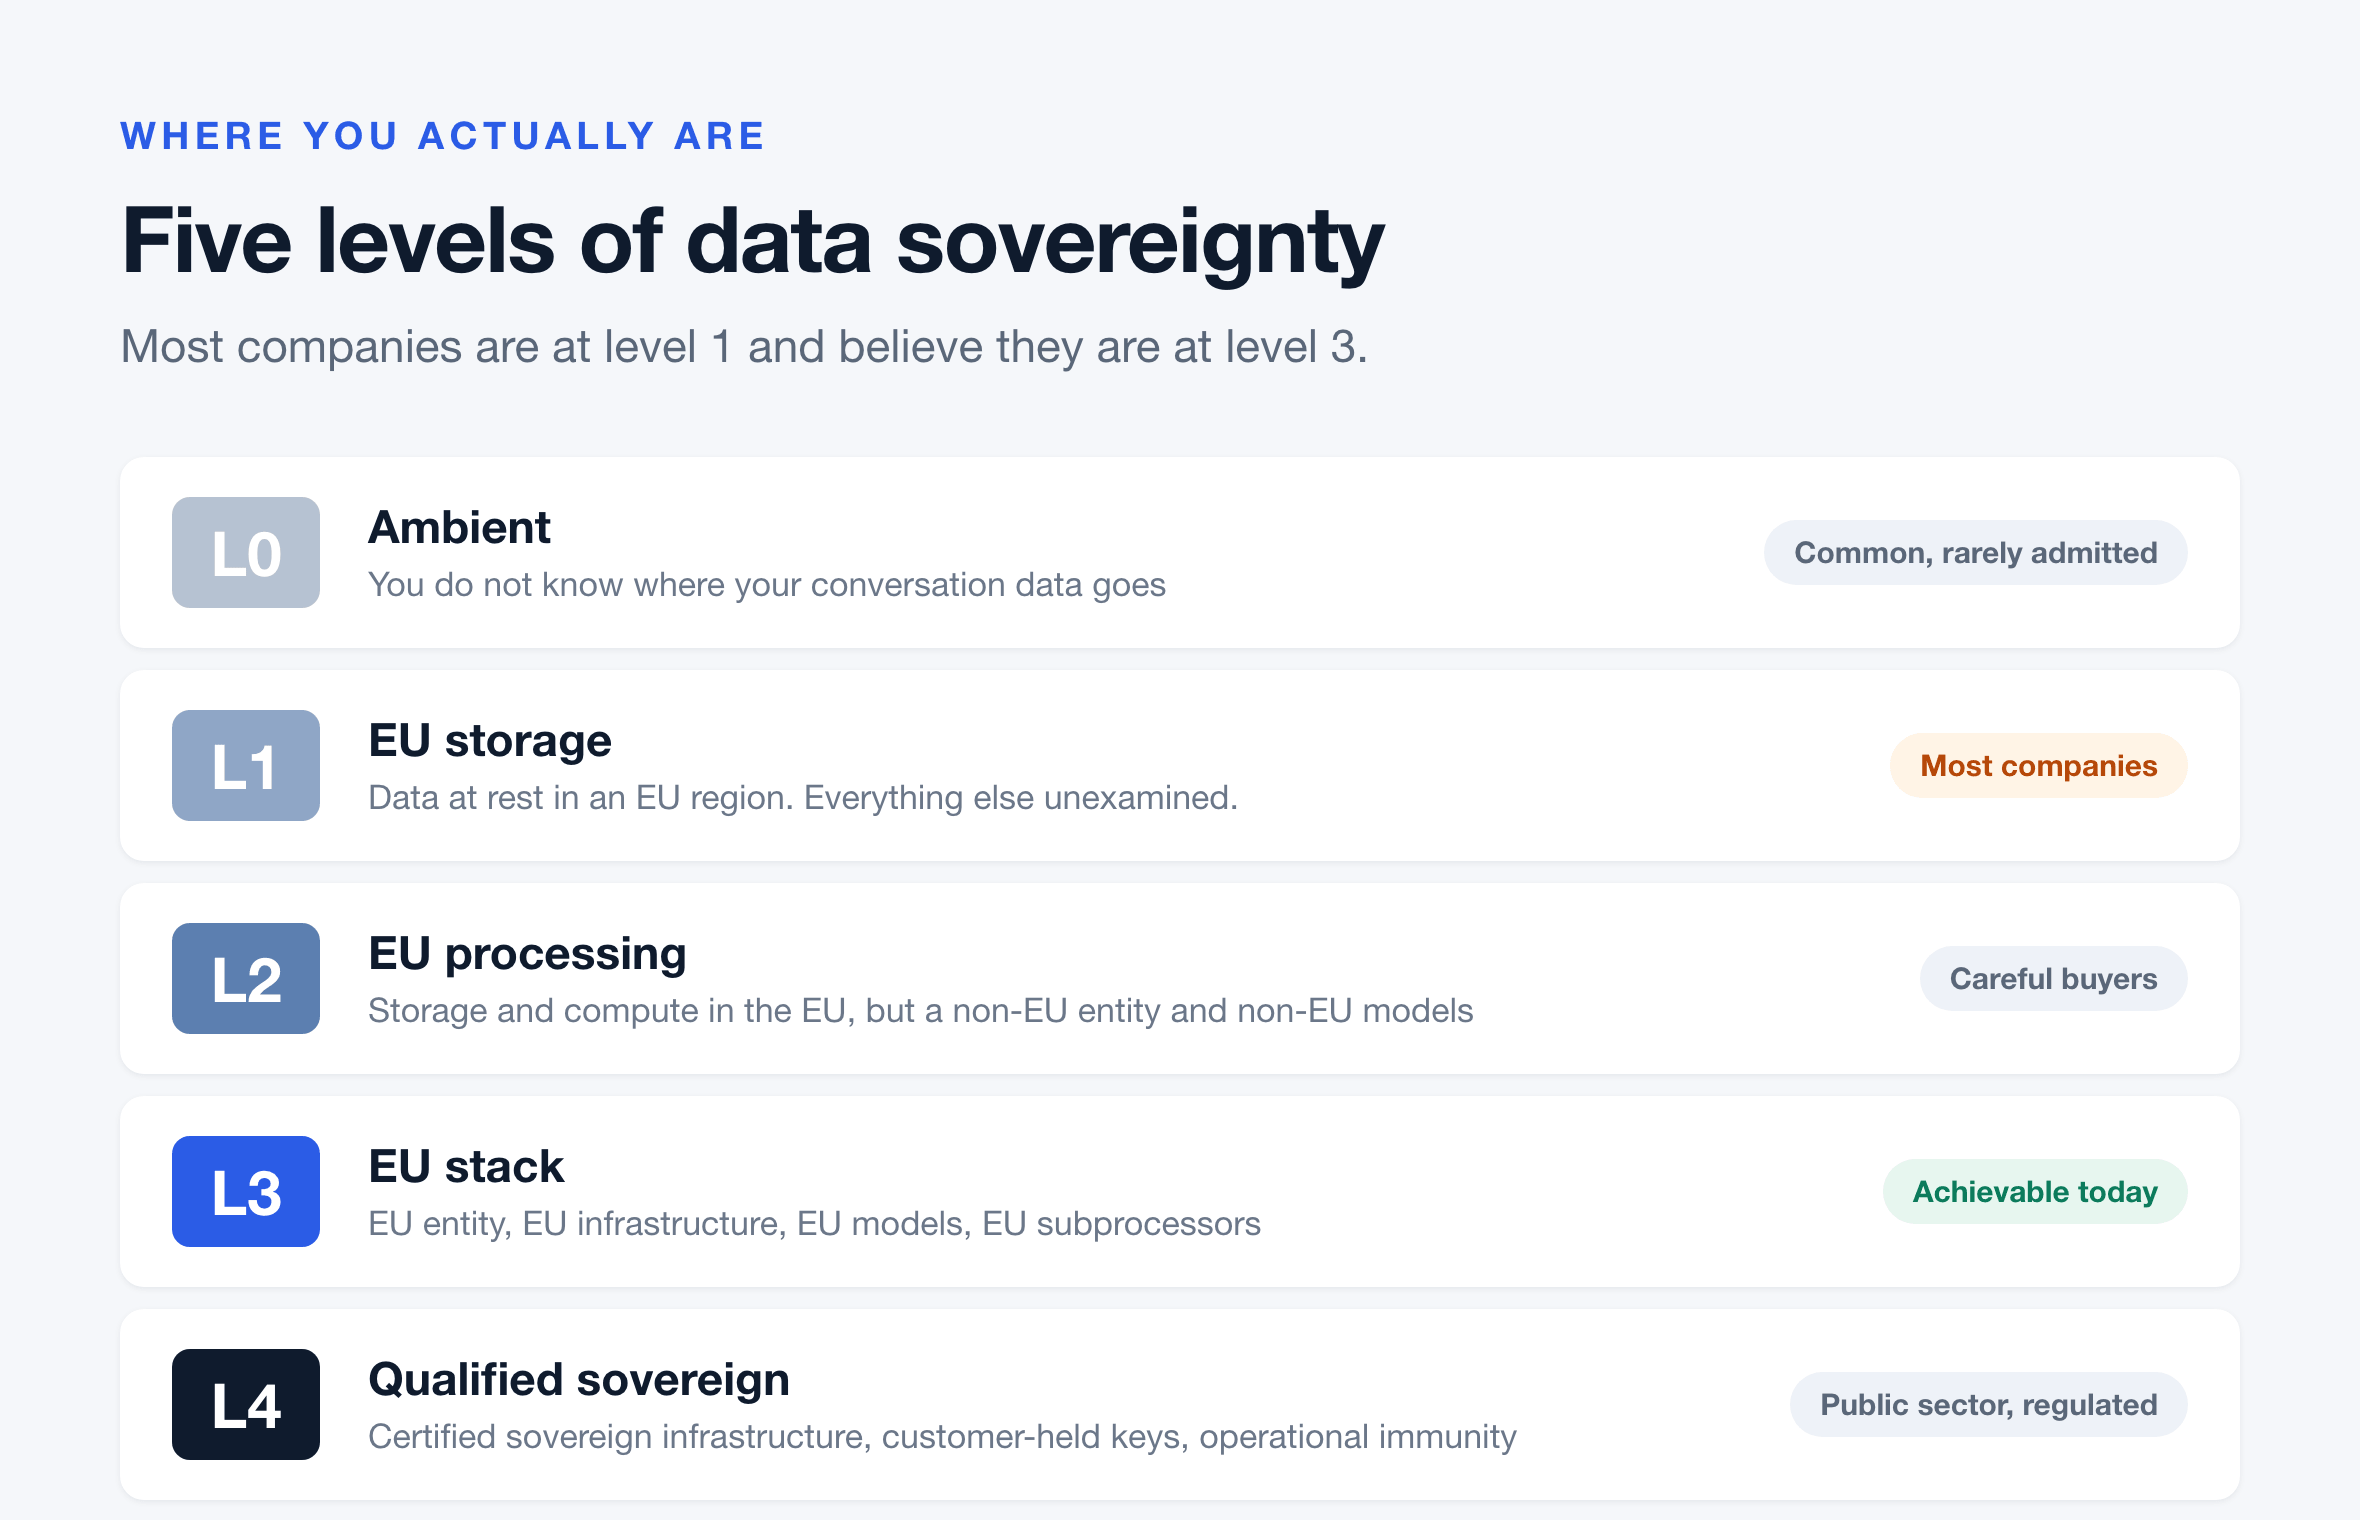
- Niveau 0 (Sans restriction) : Les invites, documents et transcriptions sont transmis vers des points de terminaison mondiaux sans aucune frontière géographique.
- Niveau 1 (Résidence des données) : Les bases de données sont situées dans une région de l'UE, mais le traitement et l'inférence sont délocalisés à l'étranger dès que l'équilibrage de charge est déclenché.
- Niveau 2 (Traitement en région) : Le stockage et les serveurs de calcul sont ancrés dans des zones européennes, mais le LLM sous-jacent interroge des API étrangères externes.
- Niveau 3 (Souveraineté des modèles) : Toute l'inférence s'exécute sur des modèles à poids ouverts hébergés sur des serveurs européens, ou utilise des fournisseurs de modèles basés dans l'UE comme Mistral AI ou Aleph Alpha.
- Niveau 4 (Autonomie opérationnelle) : Le fournisseur est une entité dont le siège social est situé dans l'UE, opère sur une infrastructure certifiée européenne, propose la gestion des clés par le client (CMK) et n'a aucune dépendance envers des sociétés mères étrangères.
4. Le paysage juridique en 2026
Le conflit lié au CLOUD Act américain
En vertu du CLOUD Act américain (Clarifying Lawful Overseas Use of Data Act), les autorités fédérales des États-Unis peuvent contraindre les fournisseurs de technologie américains à divulguer les données sous leur garde ou leur contrôle, quel que soit l'endroit où ces données sont physiquement stockées.
En juin 2025, lors d'une audition formelle devant le Sénat français sur les marchés publics et la souveraineté numérique, la direction de Microsoft France a été interrogée directement sur sa capacité à garantir que les données publiques françaises hébergées en France ne seraient jamais transférées aux autorités américaines sans l'accord juridique français. La réponse a été claire : selon le droit américain actuel, aucune entreprise américaine ne peut fournir cette garantie inconditionnelle.
Le cadre de protection des données (DPF) en appel
Bien que le cadre de protection des données UE-États-Unis serve de base actuelle aux transferts de données transatlantiques, sa pérennité juridique reste incertaine. Après l'invalidation du Safe Harbor en 2015 et du Privacy Shield en 2020, le DPF a fait face à de nouveaux défis devant les tribunaux européens. Un appel dans l'affaire Latombe est en cours, ce qui signifie que les responsables de la conformité en entreprise doivent prévoir des plans de secours plutôt que de tabler sur une adéquation permanente.
L'IA Act européen et les obligations de transparence
En vertu du règlement (UE) 2026/1744, les délais pour les systèmes d'IA autonomes à haut risque ont été reportés à décembre 2027. Cependant, les obligations de transparence prévues à l'article 50 sont entrées en vigueur le 2 août 2026.
Tout système automatisé interagissant directement avec le personnel ou les clients, enregistrant des conversations ou générant du texte et des résumés synthétiques doit clairement divulguer sa nature d'IA. Les outils d'enregistrement de réunions et les robots de transcription sont directement concernés par ces dispositions d'application immédiate.
Normes et certifications
5. Exemples d'IA souveraine européenne et initiatives nationales
Les gouvernements et les équipes d'ingénierie à travers l'Europe développent des infrastructures et des architectures de modèles indépendantes afin de réduire la dépendance vis-à-vis des plateformes étrangères.
Mistral AI et les modèles de fondation européens (France)
Basée à Paris, Mistral AI est devenue une pierre angulaire de la souveraineté européenne en matière de modèles. En publiant des modèles à poids ouverts (tels que Mistral Small, NeMo et Large) et en proposant des points de terminaison d'API européens dédiés, Mistral permet aux entreprises de déployer des modèles de raisonnement de pointe entièrement au sein de leurs propres clouds privés virtuels ou sur des plateformes d'hébergement européennes comme Scaleway et OVHcloud.
BgGPT et l'infrastructure linguistique d'Europe de l'Est (Bulgarie)
Développé par l'institut INSAIT à Sofia en partenariat avec le gouvernement bulgare, BgGPT représente un modèle national souverain dédié. Conçu spécifiquement pour maîtriser les nuances linguistiques bulgares, les archives du secteur public et la documentation réglementaire régionale, il fonctionne entièrement sur des nœuds de calcul nationaux pour soutenir les écoles, les administrations publiques et les entreprises locales.
COMPL-AI : Le cadre d'évaluation ouvert (Suisse / UE)
Créé grâce à une collaboration entre l'ETH Zurich, l'INSAIT et des laboratoires de recherche européens, COMPL-AI fournit un référentiel d'évaluation open source directement aligné sur les obligations de l'IA Act de l'UE. Il offre aux organisations une méthode reproductible et vérifiable pour tester les résultats des modèles en matière de biais, de transparence, de cybersécurité et de protection des données avant leur déploiement.
Zanus et le matériel d'inférence en périphérie (Edge)
Le déploiement de modèles sur du matériel décentralisé et sur site permet aux organisations d'éliminer totalement le transfert de données externe. Les initiatives européennes autour des puces d'inférence en périphérie et des appliances d'entreprise privées permettent aux cabinets médicaux, juridiques et financiers d'exécuter des charges de travail LLM directement dans leurs ateliers ou salles de serveurs.
Le Bureau européen de l'IA et les usines d'IA
La Commission européenne a créé le Bureau européen de l'IA pour superviser les modèles d'IA à usage général et coordonner la création d'usines européennes d'IA. Ces centres de calcul régionaux associent des supercalculateurs EuroHPC (tels que LUMI en Finlande et Leonardo en Italie) à une infrastructure énergétique propre, offrant aux startups et aux chercheurs européens la capacité de calcul nécessaire pour entraîner des modèles de pointe au niveau national.
6. Annuaire des fournisseurs européens de cloud et d'IA
Les entreprises qui souhaitent s'affranchir des dépendances étrangères disposent d'un large choix d'alternatives européennes matures :
Fournisseurs d'infrastructure cloud
Fournisseurs européens d'IA et de solutions vocales
7. Comment Noota met en œuvre la pile à quatre couches
Noota a été conçu en France pour automatiser la documentation des réunions, la transcription d'entretiens et les mises à jour CRM, tout en garantissant une stricte isolation des données en Europe :
- Stockage (Couche 1) : Les fichiers audio, les transcriptions et les notes structurées des clients sont hébergés dans des centres de données européens situés en France, en Belgique et aux Pays-Bas.
- Traitement (Couche 2) : Les pipelines de conversion multimédia et de texte s'exécutent sur Scaleway et au sein de régions cloud européennes avec une application géographique stricte.
- Inférence des modèles (Couche 3) : La transcription et la génération d'informations structurées utilisent les modèles de Gladia et de Mistral AI, exécutés sur des serveurs européens. Les données des utilisateurs ne sont jamais utilisées pour entraîner ou affiner des modèles publics.
- Gouvernance d'entreprise (Couche 4) : Noota est une société française soumise exclusivement à la juridiction française et européenne, avec un chiffrement AES-256 au repos, un chiffrement TLS 1.3 en transit et des calendriers de conservation des données personnalisables, allant de 24 heures à trois ans.
8. Le plan de migration vers la souveraineté en 30 jours
Il n'est pas nécessaire de lancer une refonte technologique à plusieurs millions d'euros pour obtenir des résultats concrets. Un programme pratique de quatre semaines permet de reprendre le contrôle sur vos données les plus sensibles.
Semaine 1 : Établir l'état des lieux
Répertoriez tous les outils actuellement utilisés pour capturer, transcrire ou traiter les communications d'entreprise (bots de visioconférence, plugins CRM, enregistreurs d'appels commerciaux, assistants de chat). Interrogez trois chefs d'équipe sur les outils utilisés par leurs collaborateurs.
Envoyez un questionnaire écrit de quatre questions à vos trois principaux fournisseurs de logiciels :
- Dans quels pays spécifiques nos données sont-elles stockées au repos ?
- Dans quels pays nos données sont-elles traitées, y compris dans les caches temporaires ?
- Quels modèles spécifiques lisent nos informations, qui les détient et où l'inférence est-elle calculée ?
- Avec quelle entité juridique avons-nous contracté, où est-elle enregistrée et les données clients alimentent-elles vos modèles d'entraînement ?
Semaine 2 : Définir des objectifs par type de données
Évitez d'appliquer une norme unique à l'ensemble de votre entreprise. Catégorisez selon le niveau de sensibilité :
- Réunions d'équipe internes : Les niveaux 1 ou 2 sont souvent adaptés.
- Échanges avec les clients et les équipes commerciales : Le niveau 3 garantit la confidentialité des conditions commerciales.
- Entretiens de direction, RH et candidats : Les niveaux 3 ou 4 protègent les données personnelles et les discussions liées à l'emploi.
- Documentation réglementaire et juridique : Niveau 4 avec clés dédiées et hébergement qualifié dans l'UE.
Semaine 3 : Transition d'un flux de travail critique
Choisissez votre flux de travail le plus sensible, comme les appels de découverte client ou les entretiens de direction. Orientez les nouvelles sessions vers une solution souveraine européenne. Utilisez le nouvel outil parallèlement aux archives existantes sans tenter de migration complexe des données historiques.
Semaine 4 : Documentez votre politique
Produisez un résumé clair d'une page documentant votre pile applicative, les classifications de données, les zones d'hébergement actives et les engagements des fournisseurs. Ce document permet à votre responsable de la conformité, à votre conseil d'administration et à vos clients entreprises d'obtenir une vérification immédiate lors des audits de sécurité.
Prochaines étapes
Auditez votre empreinte de communication dès aujourd'hui :
- Listez les outils qui enregistrent les discussions au sein de vos départements.
- Vérifiez où chaque outil traite l'audio, exécute l'inférence des modèles et stocke les fichiers.
- Évaluez votre niveau de conformité avec l'espace de travail européen de Noota.
À propos de l'auteur
Jean-marc est un expert IA qui aide les recruteurs et les professionnels à tirer parti de ces outils au quotidien.
FAQ
Le chiffrement protège contre l'interception réseau par des tiers non autorisés. Cependant, si votre fournisseur cloud gère les clés de chiffrement, il peut être légalement contraint de déchiffrer les données sur ordonnance judiciaire. L'utilisation de clés gérées par le client (CMK), où vous conservez la garde du HSM, réduit considérablement ce risque, bien que les données doivent être déchiffrées dans la mémoire système lors de l'inférence active.
Choisir une région UE répond aux exigences de base en matière de résidence des données (couche 1). Cela garantit que les données au repos sont stockées dans un centre de données régional. Toutefois, cela ne modifie pas les obligations de déclaration du fournisseur envers les tribunaux étrangers (couche 4), et ne garantit pas non plus que l'inférence LLM sous-jacente à l'application reste dans les frontières européennes (couches 2 et 3).
Pour le traitement de documents professionnels, la transcription, la synthèse, l'extraction d'entités et la classification structurée, les modèles européens comme Mistral Large et les moteurs spécialisés comme Gladia égalent, voire surpassent, les performances des alternatives mondiales généralistes. Pour les tâches créatives ouvertes, des écarts mineurs peuvent exister, mais pour les flux de travail opérationnels structurés, les solutions européennes sont parfaitement prêtes pour la production.
Les plongements vectoriels sont des représentations mathématiques de texte utilisées dans la recherche sémantique et la génération augmentée par récupération (RAG). Des techniques d'inversion permettent de reconstruire une grande partie du texte original à partir de ces vecteurs. Si votre fournisseur stocke le texte brut en Europe mais génère les vecteurs via une API ou une base de données étrangère, le contenu de vos conversations reste exposé. Appliquez aux plongements vectoriels le même niveau de classification de données qu'aux transcriptions brutes.