

Privacidad de Datos y Cumplimiento
8 min de lectura
Actualizado el:
Sep 22, 2026
IA soberana: arquitectura completa, ejemplos prácticos y guía de implementación
Comprenda qué es la IA soberana, cómo funciona la pila de cuatro capas, ejemplos europeos reales (Mistral, Scaleway, BgGPT) y cómo lograr una verdadera soberanía de datos.

La mayoría de los compradores de software empresarial creen que elegir un centro de datos europeo garantiza la soberanía de su inteligencia artificial.
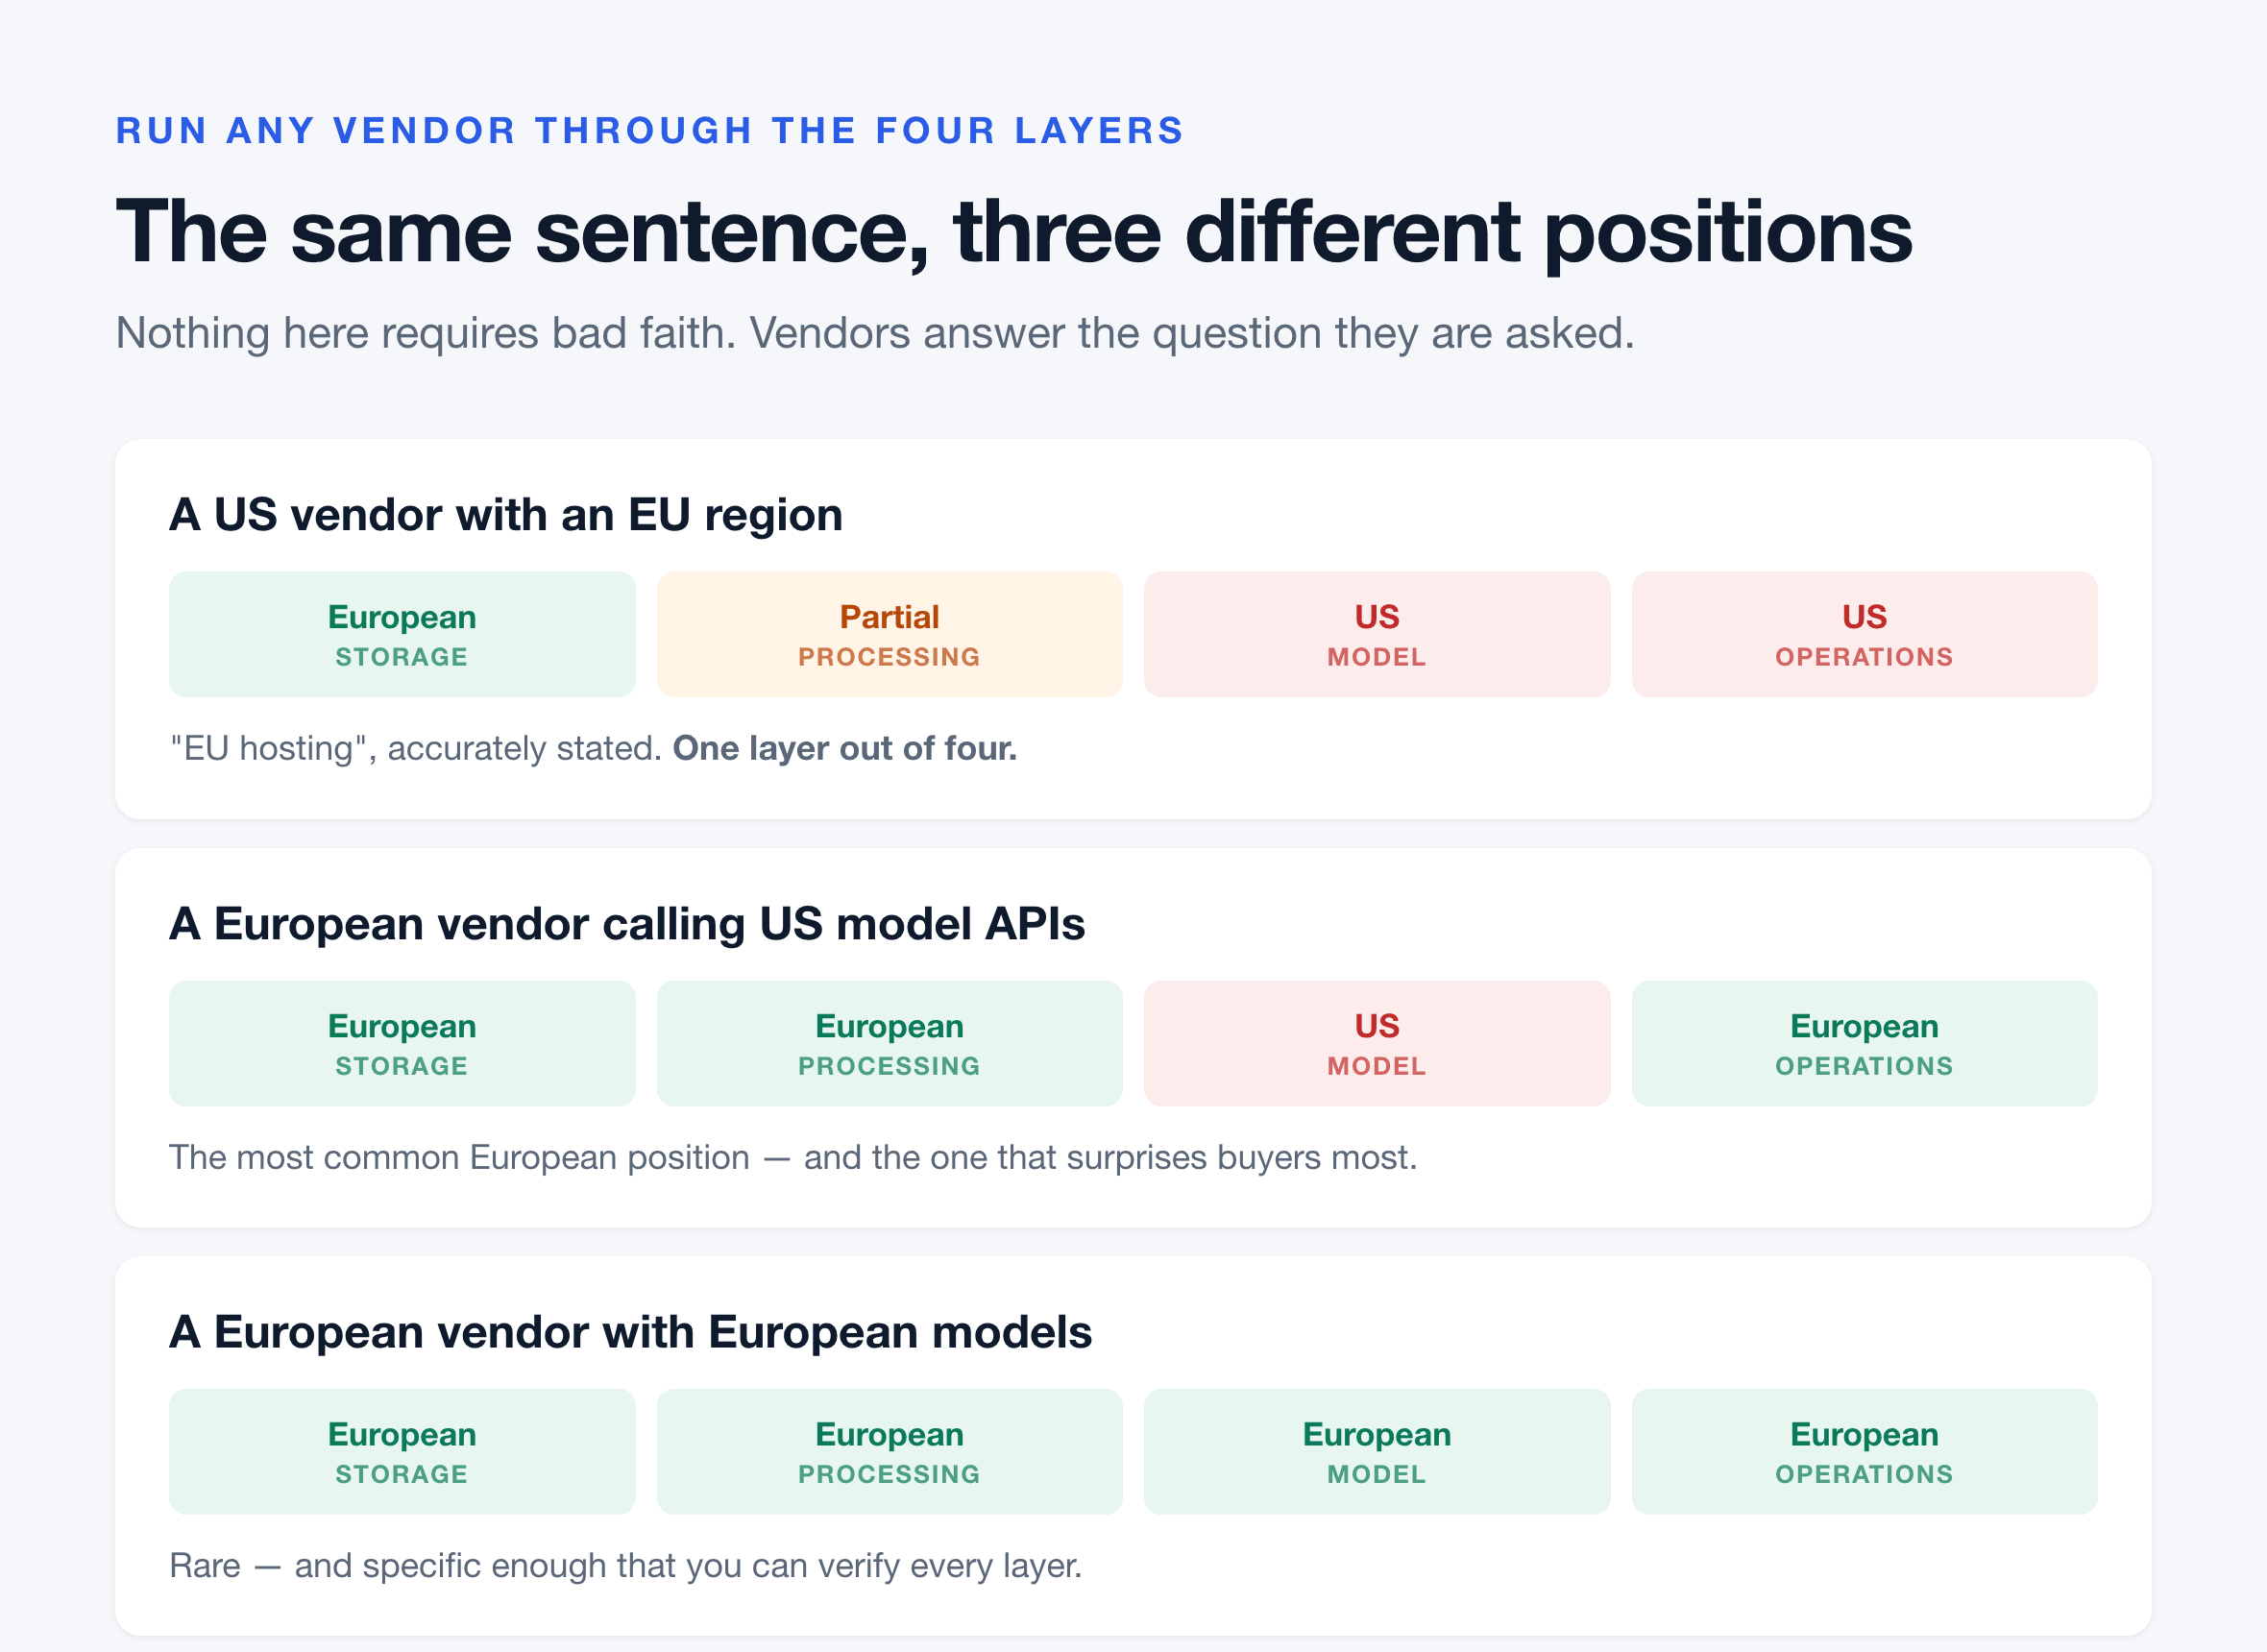
En la práctica, la ubicación física es solo una parte de la ecuación. Un servidor en París operado por una corporación de Delaware, que consulta una API de modelo alojada en Virginia, sigue estando sujeto a las citaciones judiciales estadounidenses, independientemente de la bandera que ondee en la puerta del centro de datos.
Esta guía define qué es realmente la IA soberana, desglosa las cuatro capas distintas de la pila de soberanía, analiza los modelos e infraestructuras europeos existentes, examina las iniciativas nacionales en todo el continente y traza una hoja de ruta de 30 días para auditar y asegurar los flujos de trabajo de su empresa.
1. ¿Qué es la IA soberana?
La IA soberana se refiere a sistemas de inteligencia artificial diseñados, alojados, operados y gobernados dentro de una jurisdicción legal específica. Garantiza que una organización o nación mantenga la autoridad total sobre sus datos, pesos de modelos, infraestructura de computación y flujos de trabajo operativos, sin exposición a leyes extranjeras ni mandatos de acceso externo.
2. La pila de soberanía de cuatro capas
Un sistema de IA típico consta de cuatro capas independientes. Cada capa puede residir en una jurisdicción diferente. Cuando un proveedor afirma ofrecer "alojamiento en la UE", casi siempre se refiere únicamente a la Capa 1.
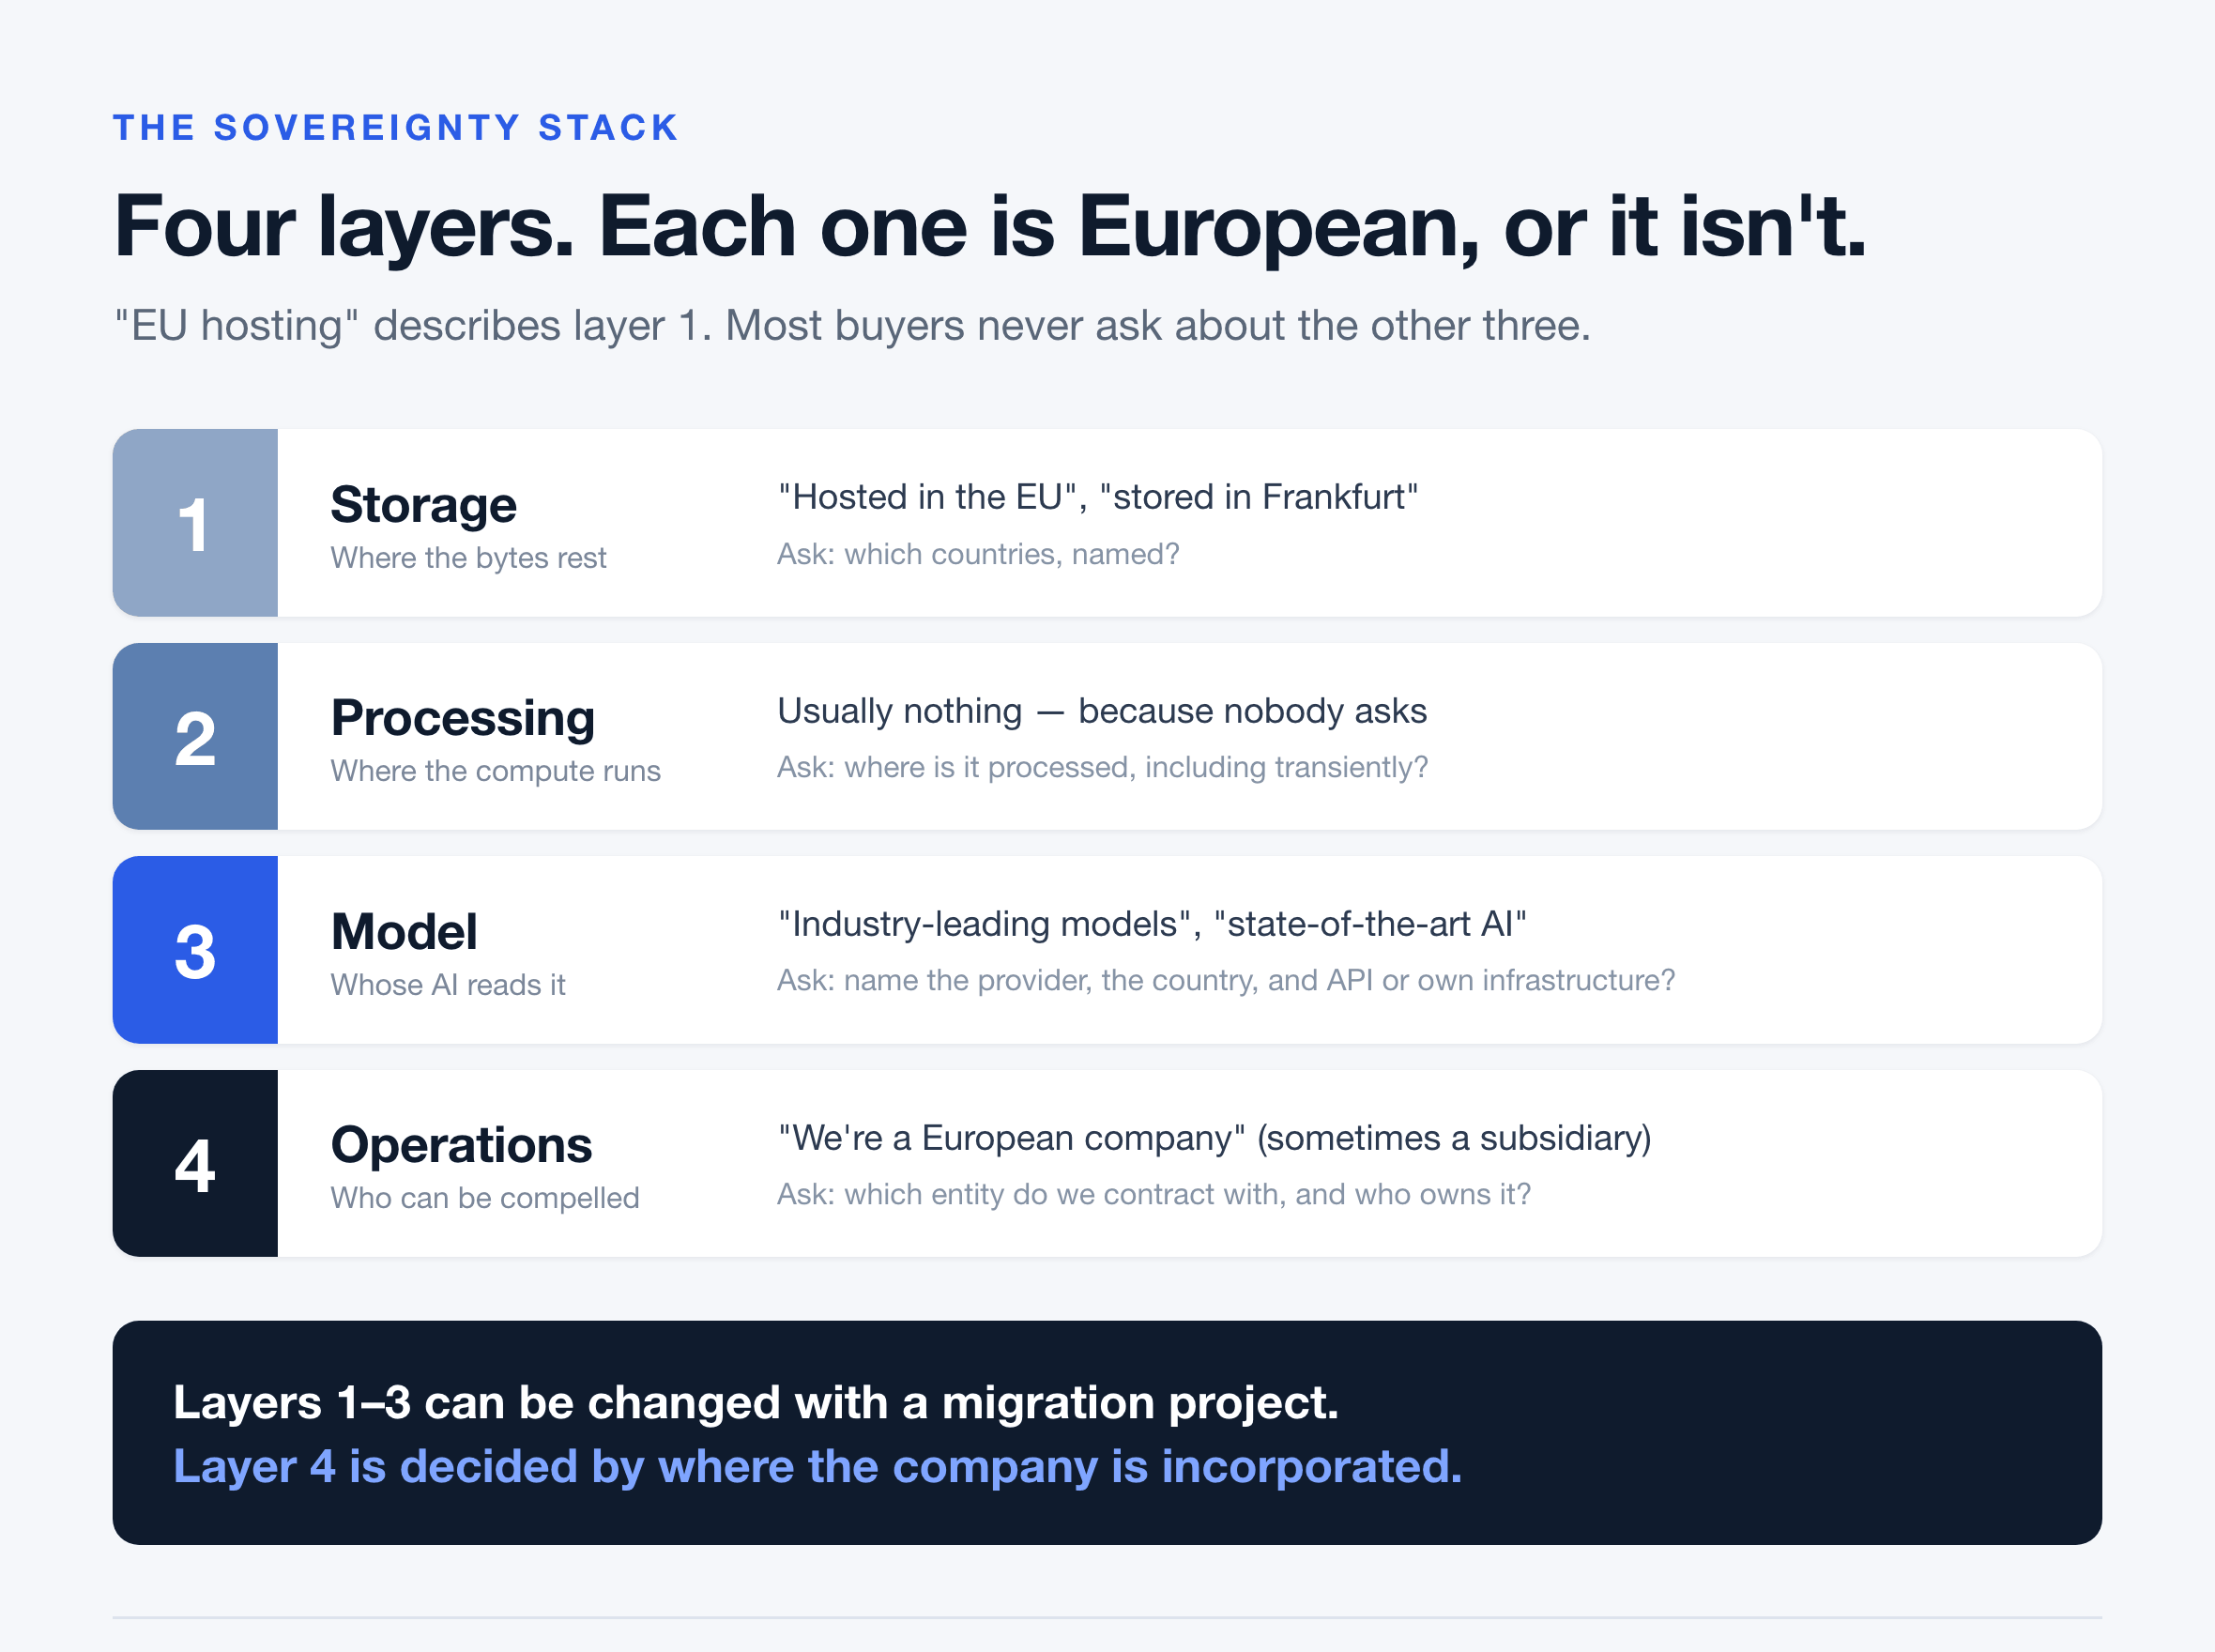
Capa 1: Almacenamiento (datos en reposo)
Esto abarca los discos duros y clústeres de bases de datos que contienen archivos, registros y transcripciones archivadas. Aunque las regiones de nube europeas están ampliamente disponibles a través de todos los grandes proveedores de hiperescala, la ubicación del almacenamiento no ofrece ninguna defensa contra los procesos de descubrimiento legal extranjeros si la empresa matriz está constituida en el extranjero.
Capa 2: Procesamiento (datos en tránsito)
A menudo, los datos residen en Europa pero se enrutan internacionalmente durante su ejecución. El procesamiento de voz a texto, el resumen, la búsqueda vectorial y la telemetría analítica suelen ejecutarse en clústeres de servidores dispersos. Según el RGPD, cada salto de tránsito individual a través de fronteras constituye una transferencia internacional de datos que requiere un mecanismo legal válido.
Capa 3: Modelo e inferencia
La capa de modelo es donde el contenido completo de sus datos empresariales se lee en texto plano. Cuando una aplicación consulta la API de un modelo de terceros, sus datos abandonan la infraestructura de la aplicación y entran en el proceso de tratamiento del proveedor del modelo.
Aquí existe una distinción arquitectónica esencial:
- Modelos de pesos abiertos en computación privada europea: Los pesos del modelo se ejecutan en instancias europeas dedicadas. Los datos nunca abandonan su entorno controlado.
- Llamadas a API de terceros: Cada solicitud sale de la red de su proveedor y entra en la nube de un tercero, sujeta a los términos operativos y a la jurisdicción de dicho tercero.
Capa 4: Operaciones corporativas y jurisdicción legal
La Capa 4 es estructural. Depende de dónde esté constituido el proveedor de software, quién sea el propietario de su empresa matriz, quién posea las claves criptográficas y qué empleados tengan acceso administrativo raíz a los sistemas de producción. Una filial europea de una entidad extranjera sigue estando legalmente sujeta a las órdenes de los tribunales del país de origen de su empresa matriz.
3. La escala de soberanía de 5 niveles
Las organizaciones pueden determinar su situación actual comparando sus aplicaciones con esta escala:
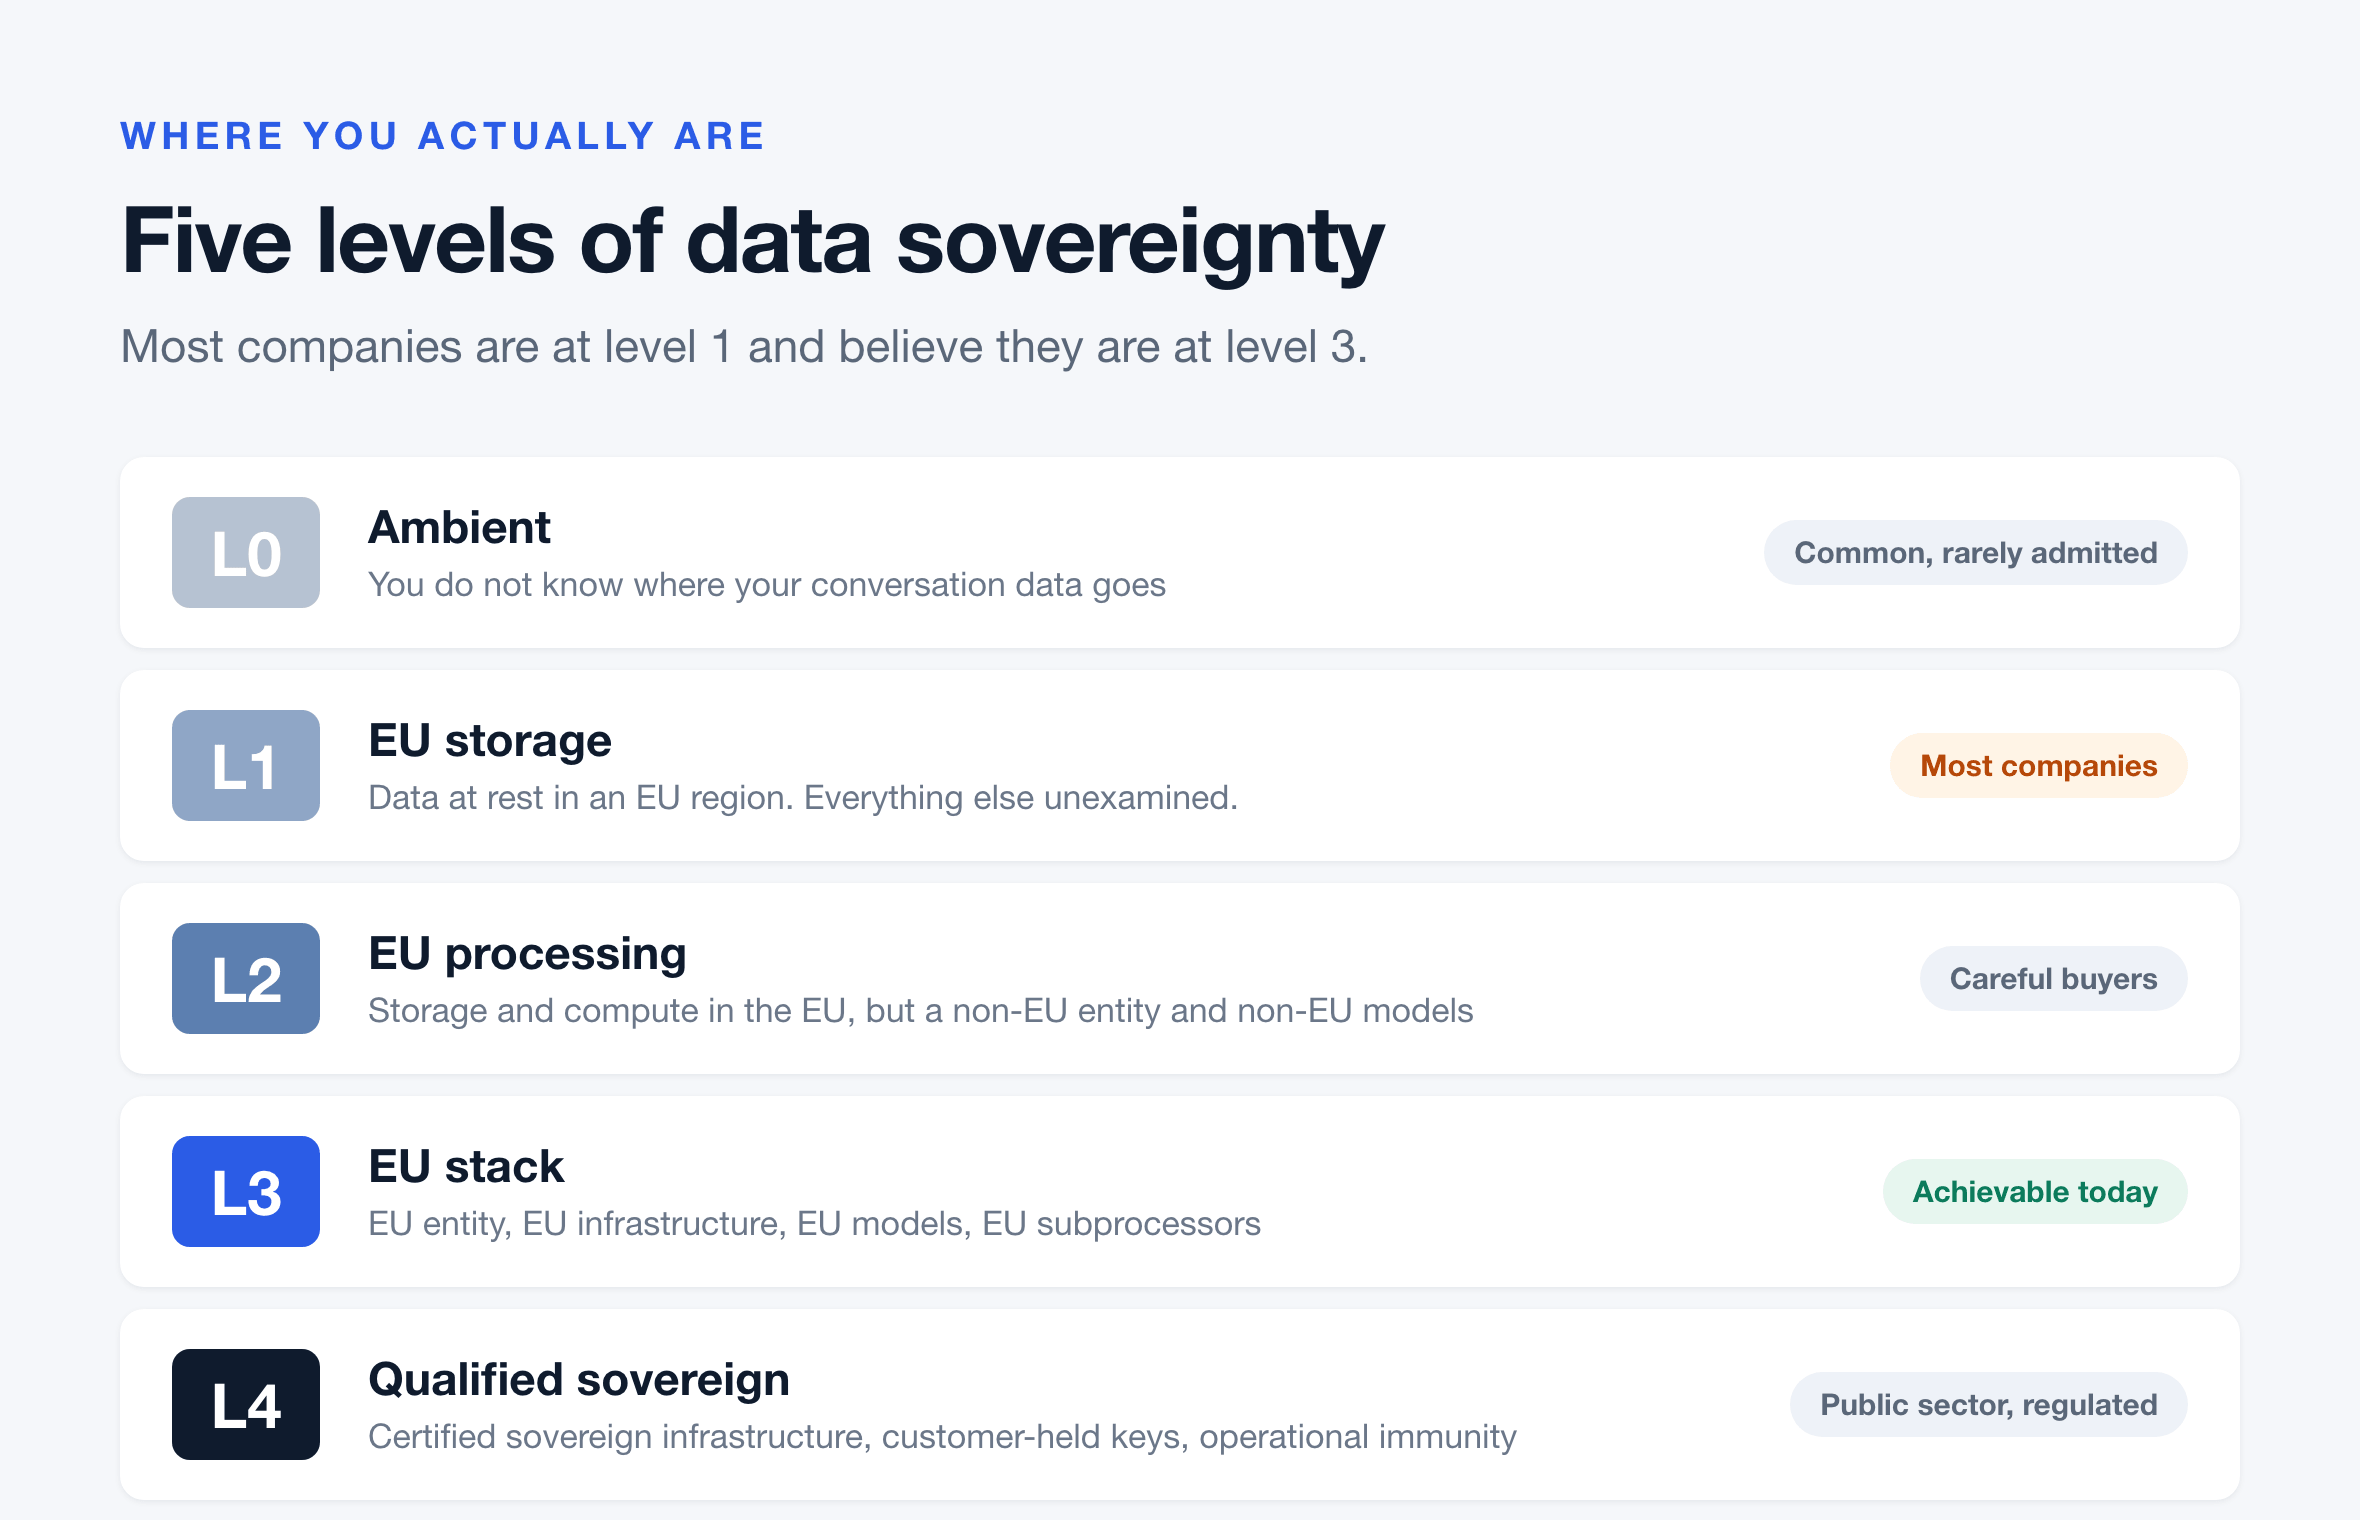
- Nivel 0 (Sin restricciones): Los prompts, documentos y transcripciones se transmiten a puntos finales globales sin límites geográficos.
- Nivel 1 (Residencia de datos): Las bases de datos se encuentran en una región de la UE, pero el procesamiento y la inferencia se trasladan al extranjero siempre que se activa el equilibrio de carga.
- Nivel 2 (Procesamiento en la región): El almacenamiento y los servidores de computación están fijados en zonas europeas, pero el LLM subyacente consulta API extranjeras externas.
- Nivel 3 (Soberanía del modelo): Toda la inferencia se ejecuta con pesos abiertos alojados en servidores europeos, o utiliza proveedores de modelos con sede en la UE como Mistral AI o Aleph Alpha.
- Nivel 4 (Autonomía operativa): El proveedor es una entidad con sede en la UE, opera en infraestructura certificada de la UE, ofrece claves gestionadas por el cliente (CMK) y no tiene dependencia alguna de empresas matrices extranjeras.
4. El panorama legal de 2026
El conflicto con la Ley CLOUD de EE. UU.
Bajo la Ley CLOUD de EE. UU. (Ley de Aclaración del Uso Legal de Datos en el Extranjero), las autoridades federales de los Estados Unidos pueden obligar a los proveedores de tecnología estadounidenses a revelar datos bajo su custodia o control, independientemente de dónde estén almacenados físicamente.
En junio de 2025, durante una investigación formal ante el Senado francés sobre contratación pública y soberanía digital, se preguntó directamente a la dirección de Microsoft Francia si podían garantizar que los datos públicos franceses alojados en Francia nunca serían transferidos a las autoridades estadounidenses sin el consentimiento legal francés. La respuesta fue clara: bajo la ley estadounidense actual, ninguna empresa de EE. UU. puede ofrecer esa garantía incondicional.
El Marco de Privacidad de Datos (DPF) bajo apelación
Aunque el Marco de Privacidad de Datos UE-EE. UU. sirve como base actual para las transferencias transatlánticas de datos, su durabilidad legal sigue siendo incierta. Tras la invalidación de Safe Harbor en 2015 y Privacy Shield en 2020, el DPF se enfrentó a nuevos desafíos en los tribunales europeos. Existe una apelación activa en el caso Latombe, lo que significa que los responsables de cumplimiento empresarial deben preparar planes de contingencia en lugar de asumir una adecuación permanente.
La Ley de IA de la UE y los mandatos de transparencia
Según el Reglamento (UE) 2026/1744, los plazos para los sistemas de IA de alto riesgo independientes se reprogramaron para diciembre de 2027. Sin embargo, los mandatos de transparencia bajo el Artículo 50 entraron en vigor el 2 de agosto de 2026.
Cualquier sistema automatizado que interactúe directamente con el personal o los clientes, capture conversaciones o genere texto y resúmenes sintéticos debe revelar claramente su naturaleza de IA. Las herramientas de grabación de reuniones y los bots de transcripción están sujetos directamente a estas disposiciones de cumplimiento inmediato.
Normas y certificaciones
5. Ejemplos de IA soberana europea e iniciativas nacionales
Los gobiernos y los equipos de ingeniería de toda Europa están construyendo infraestructuras y arquitecturas de modelos independientes para reducir la dependencia de plataformas externas.
Mistral AI y los modelos fundacionales europeos (Francia)
Con sede en París, Mistral AI se ha convertido en un pilar de la soberanía de modelos europea. Al lanzar modelos de pesos abiertos (como Mistral Small, NeMo y Large) y ofrecer puntos de conexión API europeos dedicados, Mistral permite a las empresas implementar modelos de razonamiento de vanguardia completamente dentro de sus propias nubes privadas virtuales o en plataformas de alojamiento europeas como Scaleway y OVHcloud.
BgGPT y la infraestructura lingüística de Europa del Este (Bulgaria)
Desarrollado por el instituto INSAIT en Sofía en colaboración con el gobierno búlgaro, BgGPT representa un modelo nacional soberano dedicado. Creado específicamente para dominar los matices lingüísticos, los registros del sector público y la documentación normativa regional de Bulgaria, opera íntegramente en nodos de computación nacionales para dar soporte a escuelas, administraciones públicas y empresas locales.
COMPL-AI: El marco de evaluación abierto (Suiza / UE)
Creado mediante la colaboración entre ETH Zurich, INSAIT y laboratorios de investigación europeos, COMPL-AI proporciona un punto de referencia de evaluación de código abierto directamente alineado con las obligaciones de la Ley de IA de la UE. Ofrece a las organizaciones un método repetible y verificable para probar los resultados de los modelos en cuanto a sesgos, transparencia, ciberseguridad y protección de datos antes de su implementación.
Zanus y hardware de inferencia en el borde (edge)
Implementar modelos en hardware descentralizado y local permite a las organizaciones eliminar por completo la transferencia de datos externa. Las iniciativas europeas en torno a chips de inferencia en el borde y dispositivos empresariales privados permiten a las firmas médicas, legales y financieras ejecutar cargas de trabajo de LLM directamente en plantas industriales o salas de servidores de oficinas.
La Oficina Europea de IA y las Fábricas de IA
La Comisión Europea estableció la Oficina Europea de IA para supervisar los modelos de IA de propósito general y coordinar la creación de Fábricas de IA europeas. Estos centros de computación regionales combinan superordenadores EuroHPC (como LUMI en Finlandia y Leonardo en Italia) con infraestructuras de energía limpia, proporcionando a las empresas emergentes y a los investigadores europeos la capacidad de computación necesaria para entrenar modelos de frontera a nivel nacional.
6. Directorio de proveedores europeos de nube e IA
Las empresas que se alejan de las dependencias extranjeras cuentan con una amplia selección de alternativas europeas maduras:
Proveedores de infraestructura en la nube
Proveedores europeos de IA y voz
7. Cómo implementa Noota la pila de cuatro capas
Noota fue diseñada en Francia para automatizar la documentación de reuniones, la transcripción de entrevistas y las actualizaciones de CRM, manteniendo al mismo tiempo un estricto aislamiento de datos europeo:
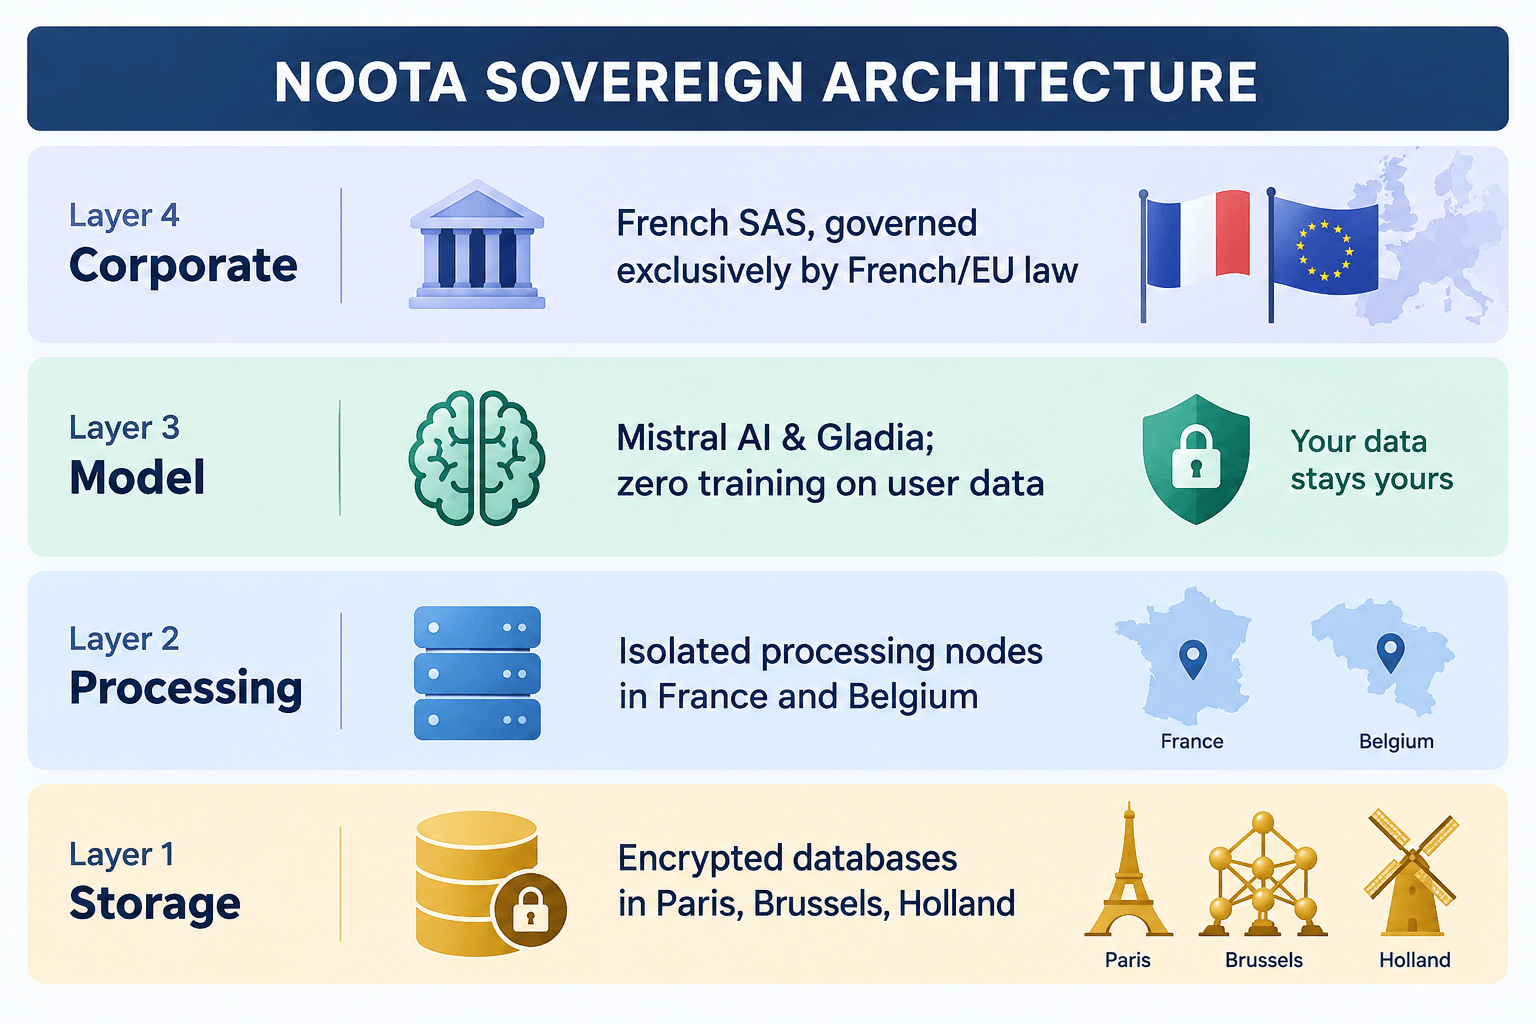
- Almacenamiento (Capa 1): El audio, las transcripciones y las notas estructuradas de los clientes residen en centros de datos europeos ubicados en Francia, Bélgica y los Países Bajos.
- Procesamiento (Capa 2): La conversión de medios y las canalizaciones de texto se ejecutan en Scaleway y en regiones de nube europeas con una estricta aplicación geográfica.
- Inferencia de modelos (Capa 3): La transcripción y la generación de información estructurada utilizan modelos de Gladia y Mistral AI que se ejecutan en infraestructura informática europea. Los datos de los usuarios nunca se utilizan para entrenar o perfeccionar modelos públicos.
- Gobierno corporativo (Capa 4): Noota es una corporación francesa sujeta exclusivamente a la jurisdicción legal francesa y europea, con cifrado AES-256 en reposo, cifrado TLS 1.3 en tránsito y calendarios de retención de datos personalizados que van desde las 24 horas hasta los tres años.
8. El plan de migración de soberanía de 30 días
No necesita una iniciativa de cambio de plataforma multimillonaria para lograr un progreso cuantificable. Una secuencia práctica de cuatro semanas puede establecer el control sobre sus datos más confidenciales.
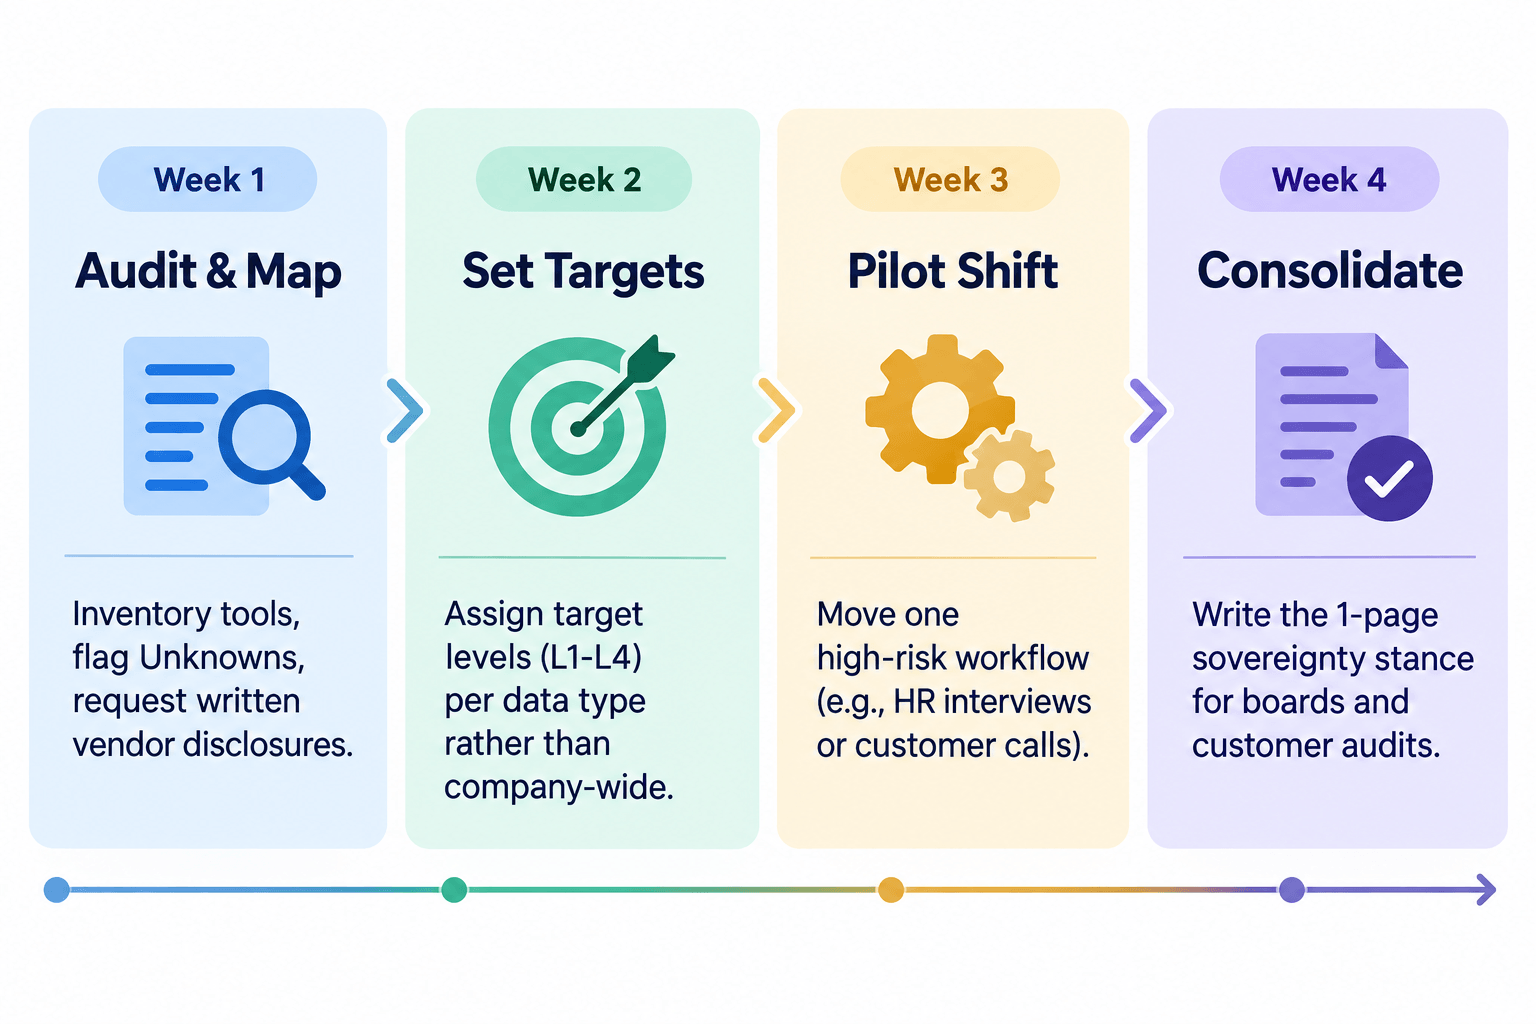
Semana 1: Establecer la base
Haga un inventario de todas las herramientas que se utilizan actualmente para capturar, transcribir o procesar las comunicaciones corporativas (bots de reuniones de video, complementos de CRM, grabadoras de ventas, asistentes de chat). Pregunte a tres líderes de equipo qué utilizan sus grupos.
Envíe una consulta por escrito de cuatro preguntas a sus tres principales proveedores de software:
- ¿En qué países específicos se almacenan nuestros datos en reposo?
- ¿En qué países se procesan nuestros datos, incluyendo las memorias caché temporales?
- ¿Qué modelos específicos leen nuestra información, quién es su propietario y dónde se calcula la inferencia?
- ¿Con qué entidad corporativa tenemos contrato, dónde está registrada y los datos de los clientes alimentan su canal de entrenamiento?
Semana 2: Definir objetivos por tipo de datos
Evite aplicar un estándar único y generalizado en toda su empresa. Clasifique según la sensibilidad:
- Reuniones internas del equipo: Los niveles 1 o 2 suelen ser prácticos.
- Conversaciones con clientes y ventas: El nivel 3 garantiza que las condiciones comerciales de los clientes permanezcan privadas.
- Entrevistas a ejecutivos, RR. HH. y candidatos: Los niveles 3 o 4 protegen los datos personales y las conversaciones sobre empleo.
- Documentación legal y regulada: Nivel 4 con claves dedicadas y alojamiento cualificado en la UE.
Semana 3: Transición de un flujo de trabajo crítico
Elija su carga de trabajo de mayor sensibilidad, como las llamadas de prospección de clientes o las entrevistas a ejecutivos. Dirija las nuevas sesiones hacia una solución soberana europea. Utilice la nueva herramienta junto con los archivos heredados sin intentar una migración compleja de los registros históricos.
Semana 4: Documente su política
Elabore un resumen claro de una página que documente su pila de aplicaciones, las clasificaciones de datos, los límites de alojamiento activos y los compromisos de los proveedores. Este documento proporciona a su responsable de cumplimiento, a la junta directiva y a sus clientes empresariales una verificación inmediata durante las auditorías de seguridad.
Próximos pasos
Audite su huella de comunicaciones hoy mismo:
- Enumere las herramientas que capturan las conversaciones en sus departamentos.
- Verifique dónde procesa cada herramienta el audio, ejecuta la inferencia del modelo y almacena los archivos.
- Revise su preparación para el cumplimiento con el espacio de trabajo europeo de Noota.
Conoce al autor
Jean-marc escribe sobre análisis de tomadores de notas con IA, gestión de reuniones, grabación e IA en reclutamiento, respaldado por años de trabajo en SEO y contenido.
Preguntas frecuentes
El cifrado protege contra la interceptación de red por parte de terceros no autorizados. Sin embargo, si su proveedor de nube gestiona las claves de cifrado, este puede ser obligado legalmente a descifrar los datos bajo una orden judicial válida. El uso de claves gestionadas por el cliente (CMK), donde usted mantiene la custodia del HSM, reduce significativamente este riesgo, aunque los datos deben entrar en la memoria del sistema sin cifrar durante la inferencia activa.
Seleccionar una región de la UE satisface los requisitos básicos de residencia de datos (Capa 1). Garantiza que los datos en reposo permanezcan en un centro de datos regional. Sin embargo, esto no altera las obligaciones de información corporativa del proveedor matriz ante tribunales extranjeros (Capa 4), ni garantiza que la inferencia del LLM subyacente de la aplicación permanezca dentro de las fronteras europeas (Capas 2 y 3).
Para el procesamiento de documentos empresariales, transcripción, resumen, extracción de entidades y clasificación estructurada, los modelos europeos como Mistral Large y motores especializados como Gladia igualan o superan el rendimiento de las alternativas globales de propósito general. Para tareas creativas abiertas, pueden existir pequeñas variaciones en la capacidad, pero para flujos de trabajo operativos estructurados, las ofertas europeas están completamente listas para producción.
Las incrustaciones vectoriales (vector embeddings) son representaciones matemáticas de texto utilizadas en la búsqueda semántica y en la generación aumentada por recuperación (RAG). Las técnicas de inversión de incrustaciones hacen posible reconstruir partes sustanciales del texto original a partir de estos vectores. Si su proveedor almacena texto sin procesar en Europa pero genera las incrustaciones mediante una API o base de datos vectorial en el extranjero, el contenido de su conversación permanece expuesto. Trate las incrustaciones vectoriales con la misma clasificación de datos que las transcripciones originales.