Gegevensbescherming & Compliance
8 min leestijd
Bijgewerkt op:
Sep 22, 2026
Soevereine AI: De complete architectuur, praktische voorbeelden en implementatiegids
Ontdek wat soevereine AI is, hoe de vierlaagse stack werkt, bekijk Europese voorbeelden (Mistral, Scaleway, BgGPT) en leer hoe u echte data-soevereiniteit bereikt.

De meeste kopers van bedrijfssoftware denken dat het kiezen van een Europees datacenter hun kunstmatige intelligentie soeverein maakt.
In de praktijk is de fysieke locatie slechts een deel van het verhaal. Een server in Parijs die wordt beheerd door een bedrijf uit Delaware en die een model-API in Virginia aanroept, blijft onderworpen aan Amerikaanse dagvaardingsbevoegdheden, ongeacht de vlag die op het datacenter hangt.
Deze gids definieert wat soevereine AI werkelijk is, ontleedt de vier verschillende lagen van de soevereiniteitsstack, inventariseert bestaande Europese modellen en infrastructuurleveranciers, onderzoekt nationale initiatieven op het continent en schetst een stappenplan van 30 dagen om uw bedrijfsworkflows te auditen en te beveiligen.
1. Wat is soevereine AI?
Soevereine AI verwijst naar systemen voor kunstmatige intelligentie die zijn ontworpen, gehost, beheerd en bestuurd binnen een specifiek rechtsgebied. Het zorgt ervoor dat een organisatie of land volledige zeggenschap behoudt over zijn data, modelgewichten, rekeninfrastructuur en operationele workflows, zonder blootstelling aan buitenlandse wetgeving of externe toegangsmandaten.
2. De vier lagen van de soevereiniteitsstack
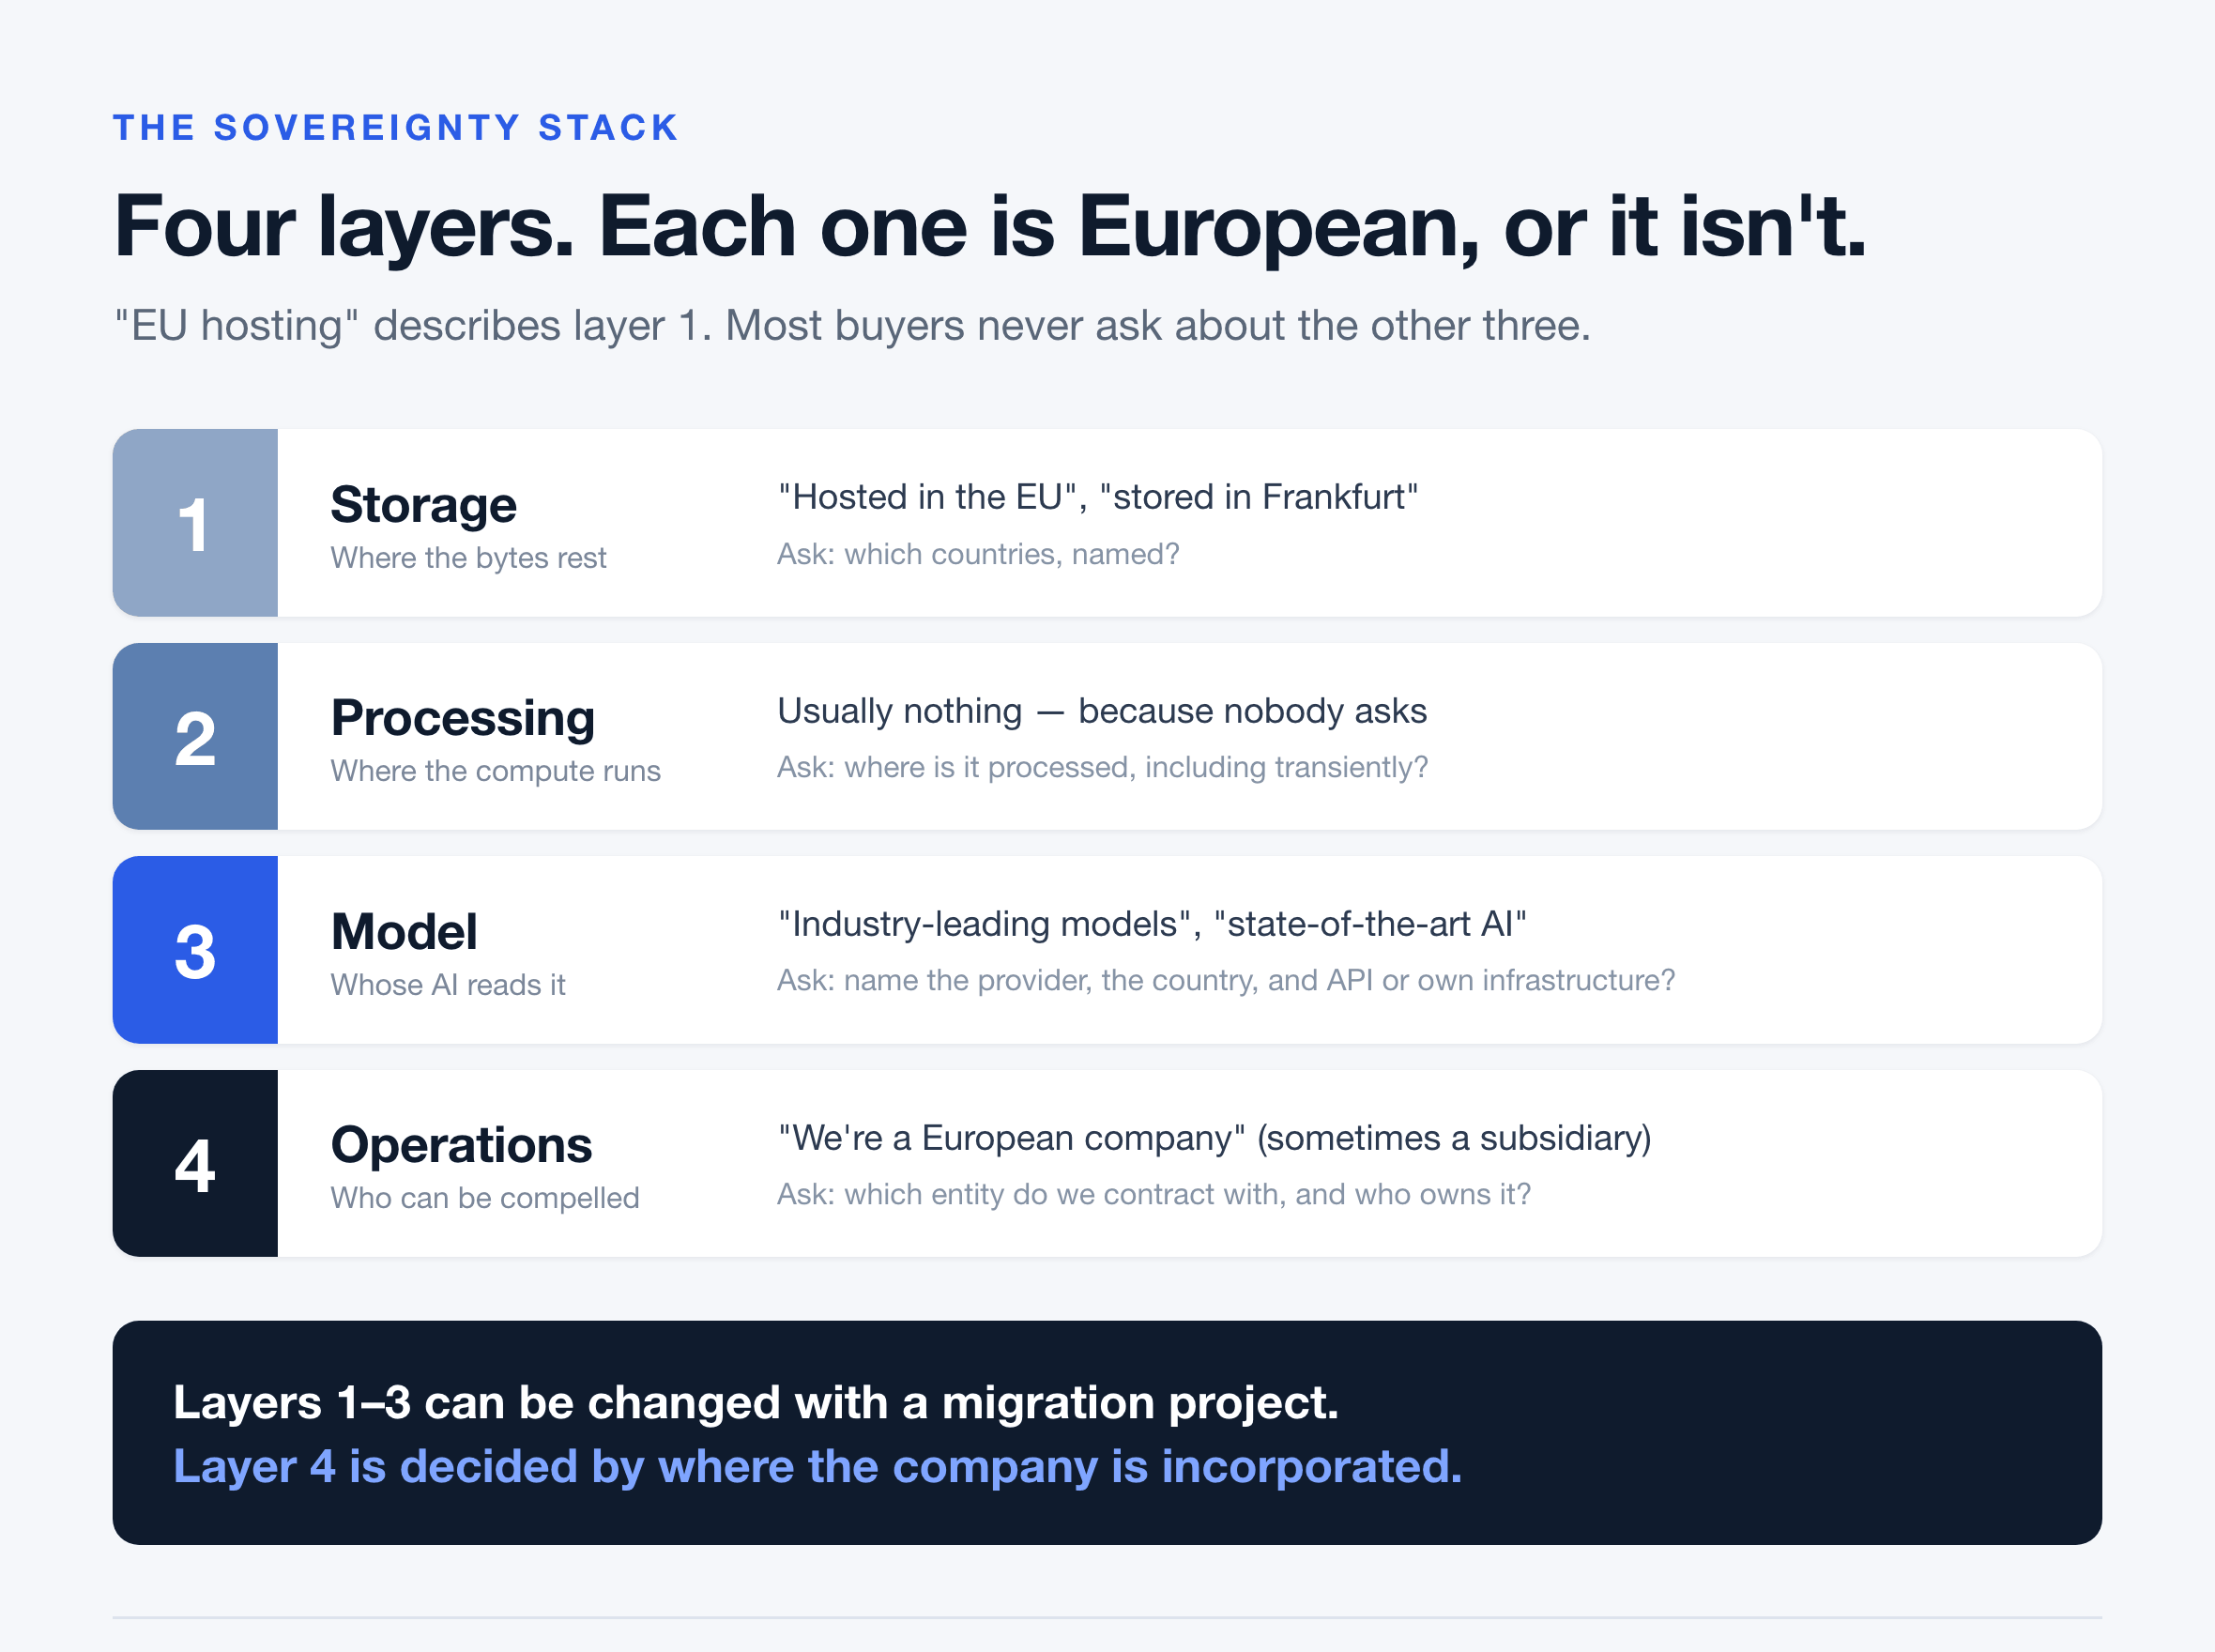
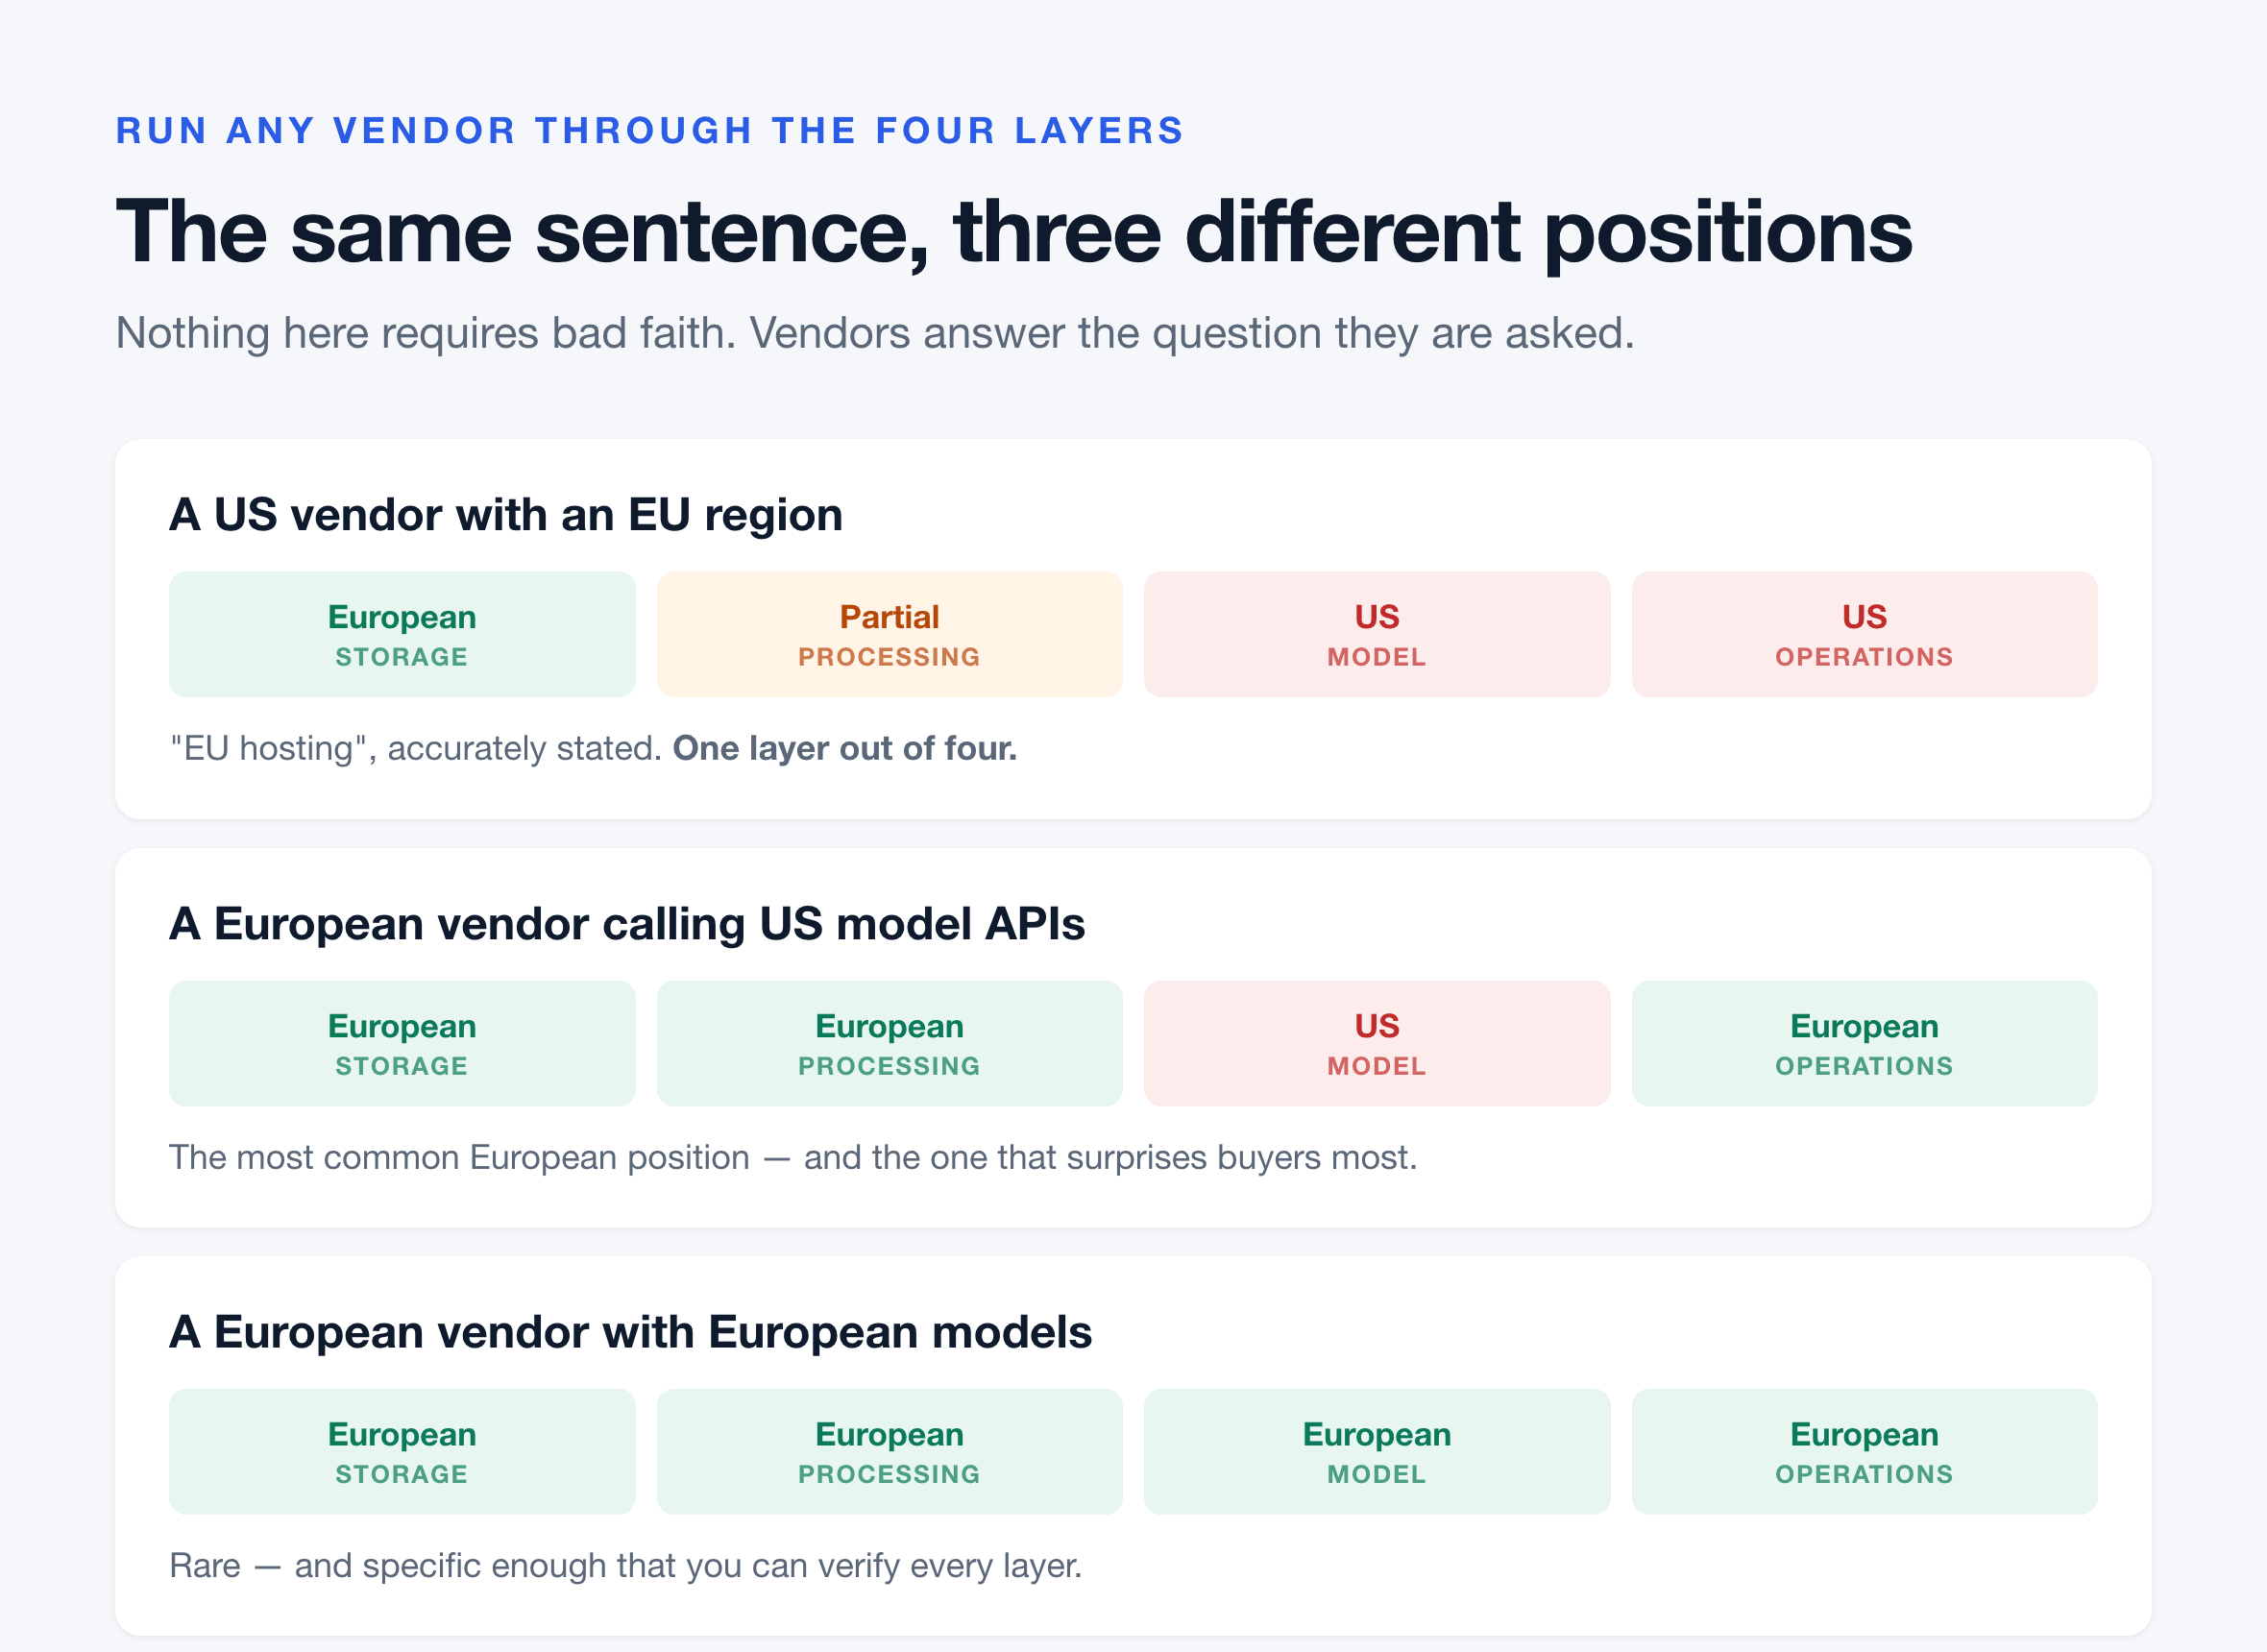
Een typisch AI-systeem bestaat uit vier onafhankelijke lagen. Elke laag kan zich in een ander rechtsgebied bevinden. Wanneer een leverancier "EU-hosting" claimt, verwijzen ze bijna altijd uitsluitend naar laag 1.
Laag 1: Opslag (Data in rust)
Dit omvat de harde schijven en databaseclusters die bestanden, databaserecords en gearchiveerde transcripties bevatten. Hoewel Europese cloudregio's breed beschikbaar zijn bij elke grote hyperscaler, biedt de opslaglocatie geen enkele bescherming tegen buitenlandse juridische vorderingen als het moederbedrijf in het buitenland is gevestigd.
Laag 2: Verwerking (Data in beweging)
Data staat vaak in Europa opgeslagen, maar wordt tijdens de uitvoering internationaal gerouteerd. Spraak-naar-tekstverwerking, samenvattingen, vectorzoekopdrachten en analytische telemetrie draaien vaak op uiteenlopende serverclusters. Onder de AVG vormt elke individuele doorgifte over de grens een internationale gegevensoverdracht waarvoor een geldig juridisch overdrachtsmechanisme vereist is.
Laag 3: Model en inferentie
De modellag is waar de volledige inhoud van uw bedrijfsgegevens in leesbare tekst wordt verwerkt. Wanneer een applicatie een API van een extern model aanroept, verlaat uw data de applicatie-infrastructuur en komt deze in de verwerkingspijplijn van de modelleverancier terecht.
Hier is een essentieel architecturaal onderscheid:
- Open-weight modellen op private Europese rekenkracht: De modelgewichten draaien op toegewezen Europese instanties. Data verlaat nooit uw gecontroleerde omgeving.
- API-aanroepen naar derden: Elk verzoek verlaat het netwerk van uw leverancier en komt terecht in de cloud van een derde partij, gebonden aan de operationele voorwaarden en het rechtsgebied van die derde partij.
Laag 4: Bedrijfsvoering en juridisch rechtsgebied
Laag 4 is structureel. Het hangt af van waar de softwareleverancier is gevestigd, wie de eigenaar is van het moederbedrijf, wie de cryptografische sleutels beheert en welke medewerkers root-beheerdersrechten hebben voor productiesystemen. Een Europese dochteronderneming van een buitenlandse entiteit blijft juridisch onderworpen aan de bevelen van de rechtbanken in het land van het moederbedrijf.
3. De 5-niveaus soevereiniteitsschaal
Organisaties kunnen hun huidige positie bepalen door hun applicaties langs deze schaal te leggen:
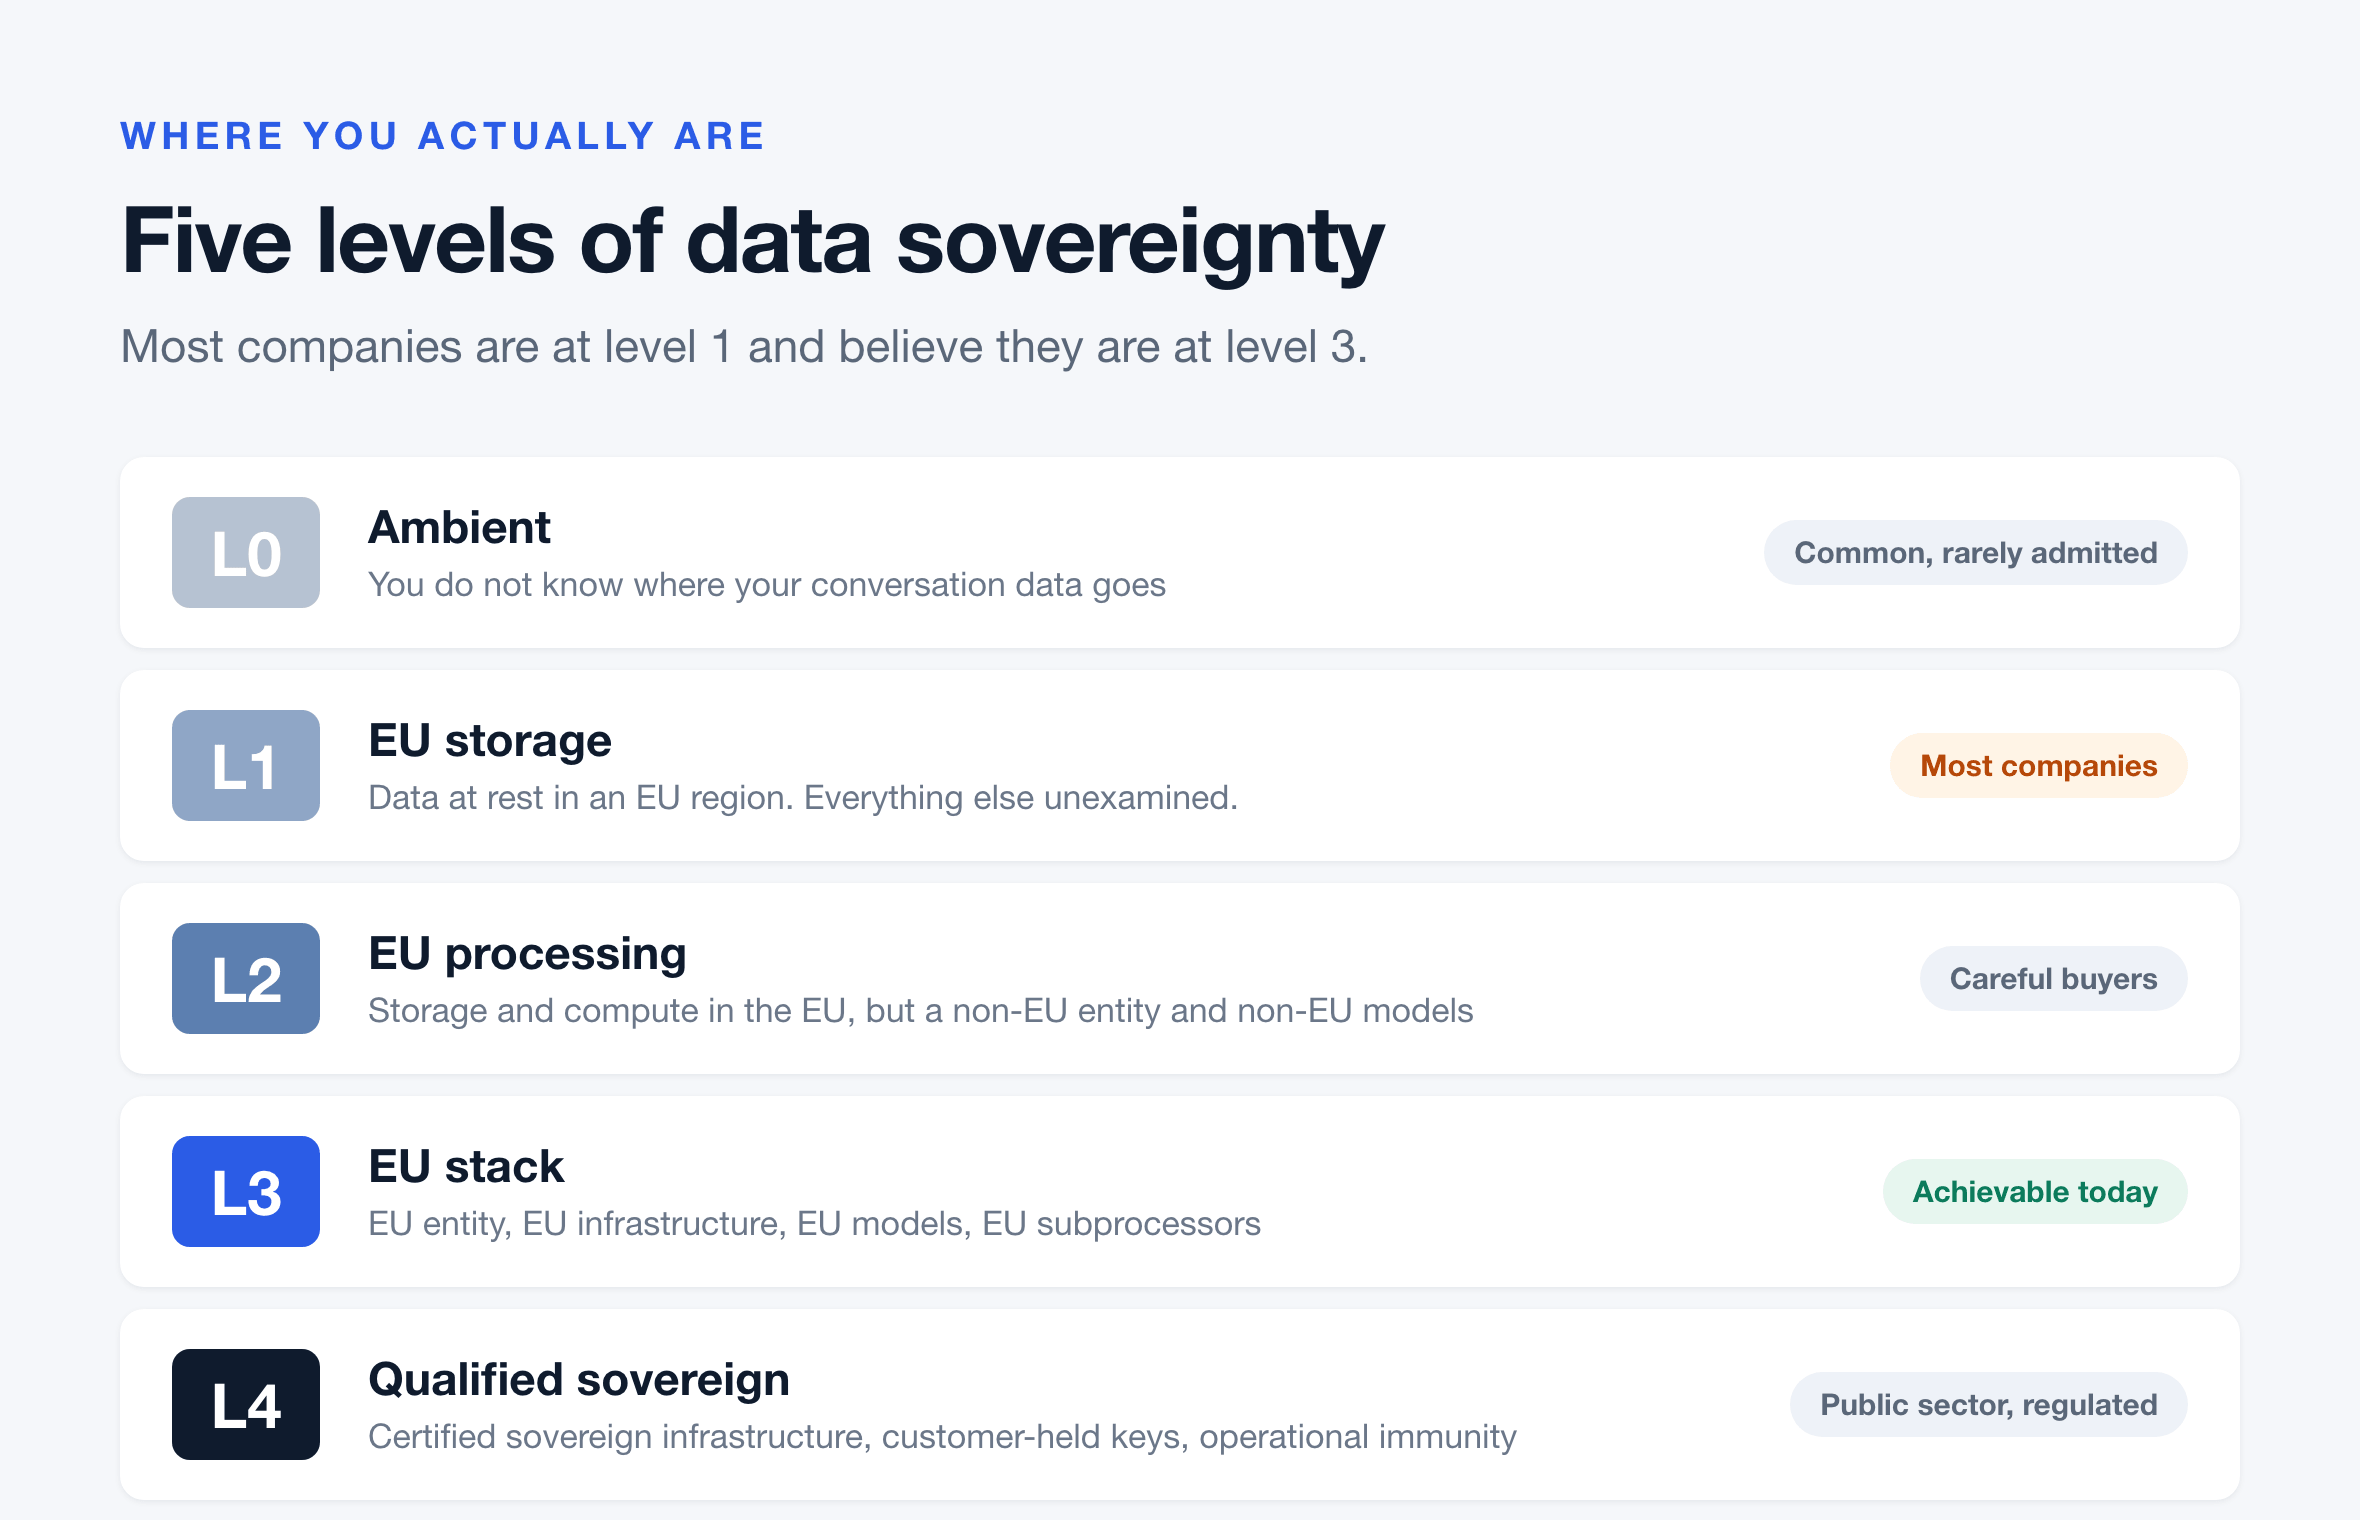
- Niveau 0 (Onbeperkt): Prompts, documenten en transcripten worden zonder geografische beperkingen naar wereldwijde eindpunten verzonden.
- Niveau 1 (Dataresidency): Databases bevinden zich in een EU-regio, maar verwerking en inferentie verplaatsen zich naar het buitenland zodra load-balancing wordt geactiveerd.
- Niveau 2 (Verwerking binnen de regio): Opslag- en rekenservers zijn vastgezet op Europese zones, maar het onderliggende LLM voert queries uit via externe buitenlandse API's.
- Niveau 3 (Modelsoevereiniteit): Alle inferentie draait op open weights die op Europese servers worden gehost, of maakt gebruik van modelaanbieders met het hoofdkantoor in de EU, zoals Mistral AI of Aleph Alpha.
- Niveau 4 (Operationele autonomie): De leverancier is een entiteit met het hoofdkantoor in de EU, opereert op gecertificeerde EU-infrastructuur, biedt door de klant beheerde sleutels (CMK) en is volledig onafhankelijk van buitenlandse moederbedrijven.
4. Het juridische landschap in 2026
Het conflict rond de Amerikaanse CLOUD Act
Onder de Amerikaanse CLOUD Act (Clarifying Lawful Overseas Use of Data Act) kunnen Amerikaanse federale autoriteiten Amerikaanse technologieleveranciers dwingen om gegevens onder hun beheer of controle openbaar te maken, ongeacht waar die gegevens fysiek zijn opgeslagen.
In juni 2025 werd de leiding van Microsoft Frankrijk tijdens een formeel onderzoek door de Franse Senaat naar overheidsopdrachten en digitale soevereiniteit direct gevraagd of zij konden garanderen dat Franse overheidsgegevens die in Frankrijk worden gehost, nooit zonder Franse juridische toestemming aan Amerikaanse autoriteiten zouden worden overgedragen. Het antwoord was duidelijk: onder de huidige Amerikaanse wetgeving kan geen enkel Amerikaans bedrijf die onvoorwaardelijke garantie bieden.
Het Data Privacy Framework (DPF) in hoger beroep
Hoewel het EU-US Data Privacy Framework momenteel de basis vormt voor trans-Atlantische gegevensoverdracht, blijft de juridische houdbaarheid onzeker. Na de ongeldigverklaring van Safe Harbor in 2015 en Privacy Shield in 2020, kreeg het DPF te maken met nieuwe uitdagingen bij Europese rechtbanken. Er loopt momenteel een beroep in de zaak-Latombe, wat betekent dat compliance-verantwoordelijken bij bedrijven zich moeten voorbereiden op noodscenario's in plaats van uit te gaan van een permanente adequaatheid.
De EU AI Act en transparantieverplichtingen
Onder Verordening (EU) 2026/1744 zijn de deadlines voor zelfstandige AI-systemen met een hoog risico verschoven naar december 2027. De transparantieverplichtingen onder artikel 50 zijn echter op 2 augustus 2026 in werking getreden.
Elk geautomatiseerd systeem dat direct interactie heeft met personeel of klanten, gesprekken vastlegt of synthetische tekst en samenvattingen genereert, moet duidelijk maken dat het om AI gaat. Tools voor het opnemen van vergaderingen en transcriptie-bots vallen direct onder deze onmiddellijke handhavingsbepalingen.
Normen en certificeringen
5. Voorbeelden van Europese soevereine AI en nationale initiatieven
Overheden en engineeringteams in heel Europa bouwen aan onafhankelijke infrastructuur en modelarchitecturen om de afhankelijkheid van externe platforms te verminderen.
Mistral AI en Europese fundamentele modellen (Frankrijk)
Het in Parijs gevestigde Mistral AI is een hoeksteen geworden van de Europese modelsoevereiniteit. Door zowel modellen met open gewichten uit te brengen (zoals Mistral Small, NeMo en Large) als speciale Europese API-eindpunten aan te bieden, stelt Mistral bedrijven in staat om geavanceerde redeneermodellen volledig binnen hun eigen virtuele private clouds of op Europese hostplatforms zoals Scaleway en OVHcloud in te zetten.
BgGPT en Oost-Europese taalinfrastructuur (Bulgarije)
BgGPT, ontwikkeld door het INSAIT-instituut in Sofia in samenwerking met de Bulgaarse overheid, is een specifiek soeverein nationaal model. Het is speciaal gebouwd om de Bulgaarse taalkundige nuances, openbare registers en regionale regelgevingsdocumentatie te beheersen en draait volledig op binnenlandse rekenknooppunten om scholen, overheidsinstanties en lokale bedrijven te ondersteunen.
COMPL-AI: Het open evaluatiekader (Zwitserland / EU)
COMPL-AI, gecreëerd door een samenwerking tussen ETH Zürich, INSAIT en Europese onderzoekslaboratoria, biedt een open-source evaluatiebenchmark die direct is afgestemd op de verplichtingen van de EU AI Act. Het geeft organisaties een herhaalbare, verifieerbare methode om modeloutputs vóór implementatie te testen op bias, transparantie, cyberbeveiliging en gegevensbescherming.
Zanus en edge-inferentiehardware
Door modellen op gedecentraliseerde, on-premise hardware te implementeren, kunnen organisaties externe gegevensoverdracht volledig elimineren. Europese initiatieven rond edge-inferentiechips en private bedrijfsapparatuur stellen medische, juridische en financiële firma's in staat om LLM-workloads direct op de werkvloer of in eigen serverruimtes uit te voeren.
Het Europese AI-bureau en AI-fabrieken
De Europese Commissie heeft het Europese AI-bureau opgericht om toezicht te houden op AI-modellen voor algemene doeleinden en de oprichting van Europese AI-fabrieken te coördineren. Deze regionale rekencentra koppelen EuroHPC-supercomputers (zoals LUMI in Finland en Leonardo in Italië) aan infrastructuur voor schone energie, waardoor Europese startups en onderzoekers de rekenkracht krijgen die nodig is om grensverleggende modellen in eigen land te trainen.
6. Gids voor Europese cloud- en AI-aanbieders
Bedrijven die afstappen van buitenlandse afhankelijkheden hebben een ruime keuze aan volwassen Europese alternatieven:
Aanbieders van cloudinfrastructuur
Europese AI- en spraakaanbieders
7. Hoe Noota de vierlaagse stack implementeert
Noota is in Frankrijk ontwikkeld om notulen van vergaderingen, transcripties van interviews en CRM-updates te automatiseren, met behoud van strikte Europese data-isolatie:
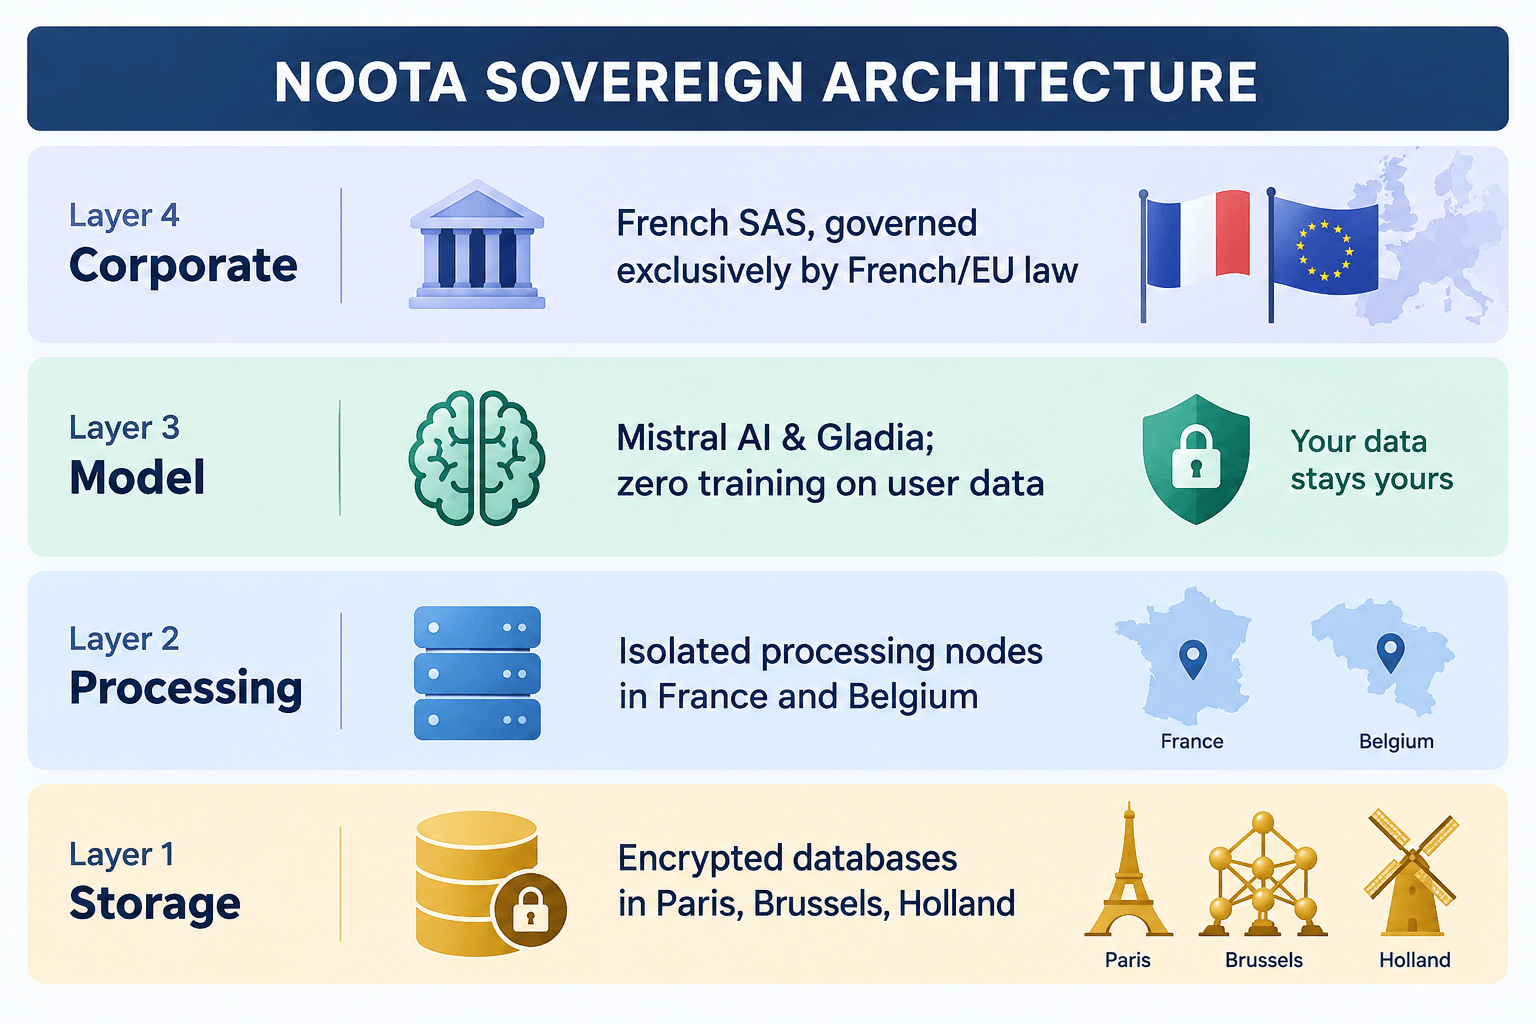
- Opslag (Laag 1): Audio van klanten, transcripties en gestructureerde notities worden opgeslagen in Europese datacenters in Frankrijk, België en Nederland.
- Verwerking (Laag 2): Mediaconversie en tekstpipelines draaien op Scaleway en in Europese cloudregio's met strikte geografische handhaving.
- Model-inferentie (Laag 3): Voor transcriptie en het genereren van gestructureerde inzichten worden Gladia- en Mistral AI-modellen gebruikt die op Europese servers draaien. Gebruikersgegevens worden nooit gebruikt om publieke modellen te trainen of te verbeteren.
- Corporate Governance (Laag 4): Noota is een Franse onderneming die uitsluitend onderworpen is aan de Franse en Europese rechtsmacht, met AES-256-encryptie in rust, TLS 1.3-encryptie tijdens transport en aangepaste bewaartermijnen voor gegevens variërend van 24 uur tot drie jaar.
8. Het 30-dagen migratieplan voor soevereiniteit
Je hebt geen miljoenenproject nodig om meetbare vooruitgang te boeken. Een praktisch traject van vier weken kan zorgen voor controle over je meest gevoelige gegevens.
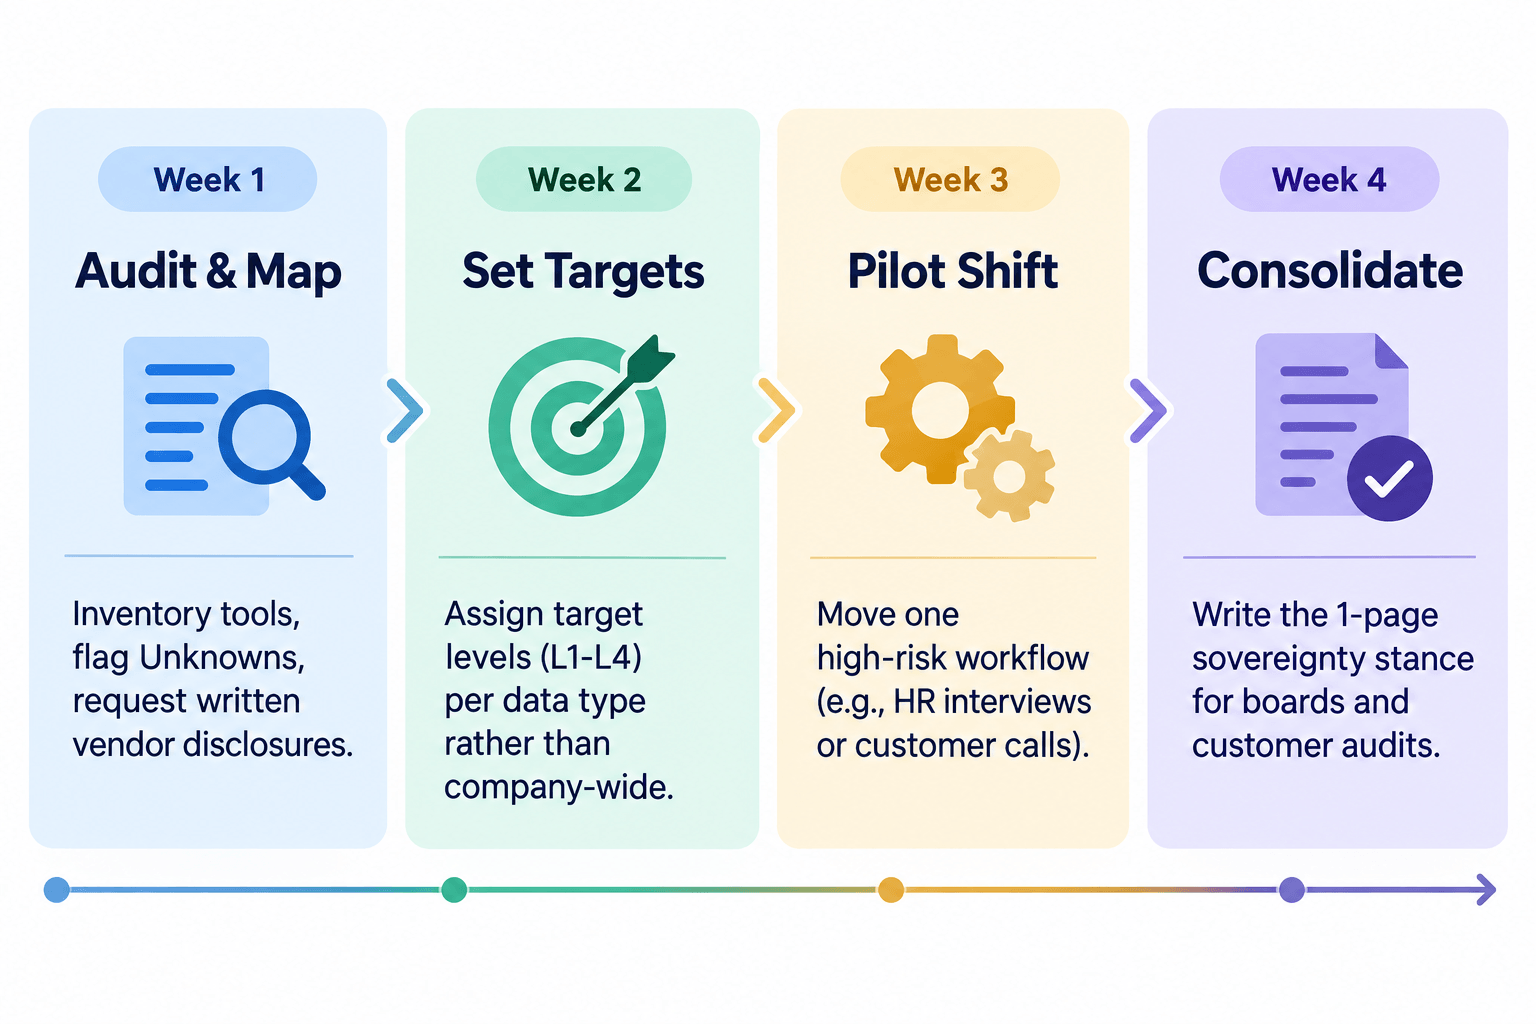
Week 1: De nulmeting vaststellen
Inventariseer elke tool die momenteel wordt gebruikt voor het vastleggen, transcriberen of verwerken van bedrijfscommunicatie (bots voor videovergaderingen, CRM-plugins, salesrecorders, chat-assistenten). Vraag drie teamleiders wat hun groepen gebruiken.
Stuur een schriftelijke vragenlijst met vier vragen naar je drie belangrijkste softwareleveranciers:
- In welke specifieke landen worden onze gegevens opgeslagen?
- In welke landen worden onze gegevens verwerkt, inclusief tijdelijke caches?
- Welke specifieke modellen lezen onze informatie, wie is de eigenaar ervan en waar vindt de inferentie plaats?
- Met welke juridische entiteit hebben wij een contract, waar is deze geregistreerd en worden klantgegevens gebruikt voor jullie trainingspipeline?
Week 2: Doelen definiëren per datatype
Vermijd het toepassen van één algemene standaard voor je hele bedrijf. Categoriseer op basis van gevoeligheid:
- Interne teamoverleggen: Niveau 1 of 2 is vaak praktisch.
- Klant- en verkoopgesprekken: Niveau 3 zorgt ervoor dat commerciële voorwaarden van klanten privé blijven.
- Executive-, HR- en sollicitatiegesprekken: Niveau 3 of 4 beschermt persoonsgegevens en arbeidsvoorwaardelijke besprekingen.
- Gereguleerde en juridische documentatie: Niveau 4 met toegewezen sleutels en gekwalificeerde EU-hosting.
Week 3: Eén kritieke workflow overzetten
Kies uw meest gevoelige werkproces, zoals klantgesprekken of executive interviews. Stuur nieuwe sessies door naar een Europese soevereine oplossing. Gebruik de nieuwe tool naast uw bestaande archieven zonder een complexe migratie van historische gegevens te proberen.
Week 4: Leg uw beleid vast
Stel een heldere samenvatting van één pagina op waarin u uw applicatiestack, dataclassificaties, actieve hostinggrenzen en leveranciersverplichtingen documenteert. Dit document biedt uw compliance officer, directie en zakelijke klanten direct bewijs tijdens beveiligingsaudits.
Volgende stappen
Audit vandaag nog uw communicatievoetafdruk:
- Maak een lijst van de tools die gesprekken binnen uw afdelingen vastleggen.
- Controleer waar elke tool audio verwerkt, modelinferentie uitvoert en bestanden opslaat.
- Beoordeel uw compliance-gereedheid met Noota's Europese werkomgeving.
Maak kennis met de auteur
Jean-marc schrijft over reviews van AI-notulisten, vergaderbeheer, opnames en AI in recruitment, met jarenlange ervaring in SEO en content.
Veelgestelde vragen
Encryptie beschermt tegen ongeautoriseerde onderschepping door derden op het netwerk. Als uw cloudprovider echter de encryptiesleutels beheert, kan deze provider wettelijk worden gedwongen om de gegevens te ontsleutelen op basis van een geldig gerechtelijk bevel. Het gebruik van door de klant beheerde sleutels (CMK), waarbij u het beheer over de HSM behoudt, verkleint dit risico aanzienlijk, hoewel gegevens tijdens actieve inferentie nog steeds ongecodeerd in het systeemgeheugen moeten worden geladen.
Het selecteren van een EU-regio voldoet aan de basisvereisten voor datalocatie (Laag 1). Het zorgt ervoor dat inactieve gegevens in een regionaal datacenter staan. Het verandert echter niets aan de rapportageverplichtingen van de moederorganisatie aan buitenlandse rechtbanken (Laag 4), en het garandeert evenmin dat de LLM-inferentie van de applicatie binnen de Europese grenzen blijft (Laag 2 en 3).
Voor het verwerken van zakelijke documenten, transcriptie, samenvattingen, entiteitextractie en gestructureerde classificatie presteren Europese modellen zoals Mistral Large en gespecialiseerde engines zoals Gladia gelijkwaardig aan of beter dan algemene wereldwijde alternatieven. Bij open creatieve taken kunnen er kleine verschillen in prestaties zijn, maar voor gestructureerde operationele workflows zijn Europese oplossingen volledig productierijp.
Vector-embeddings zijn wiskundige representaties van tekst die worden gebruikt bij semantisch zoeken en retrieval-augmented generation (RAG). Met technieken voor embedding-inversie is het mogelijk om aanzienlijke delen van de oorspronkelijke tekst uit deze vectoren te reconstrueren. Als uw leverancier ruwe tekst in Europa opslaat, maar embeddings genereert via een buitenlandse API of vectordatabase, blijft uw gespreksinhoud blootgesteld. Behandel vector-embeddings met dezelfde dataclassificatie als ruwe transcripten.